
檔案批次下載
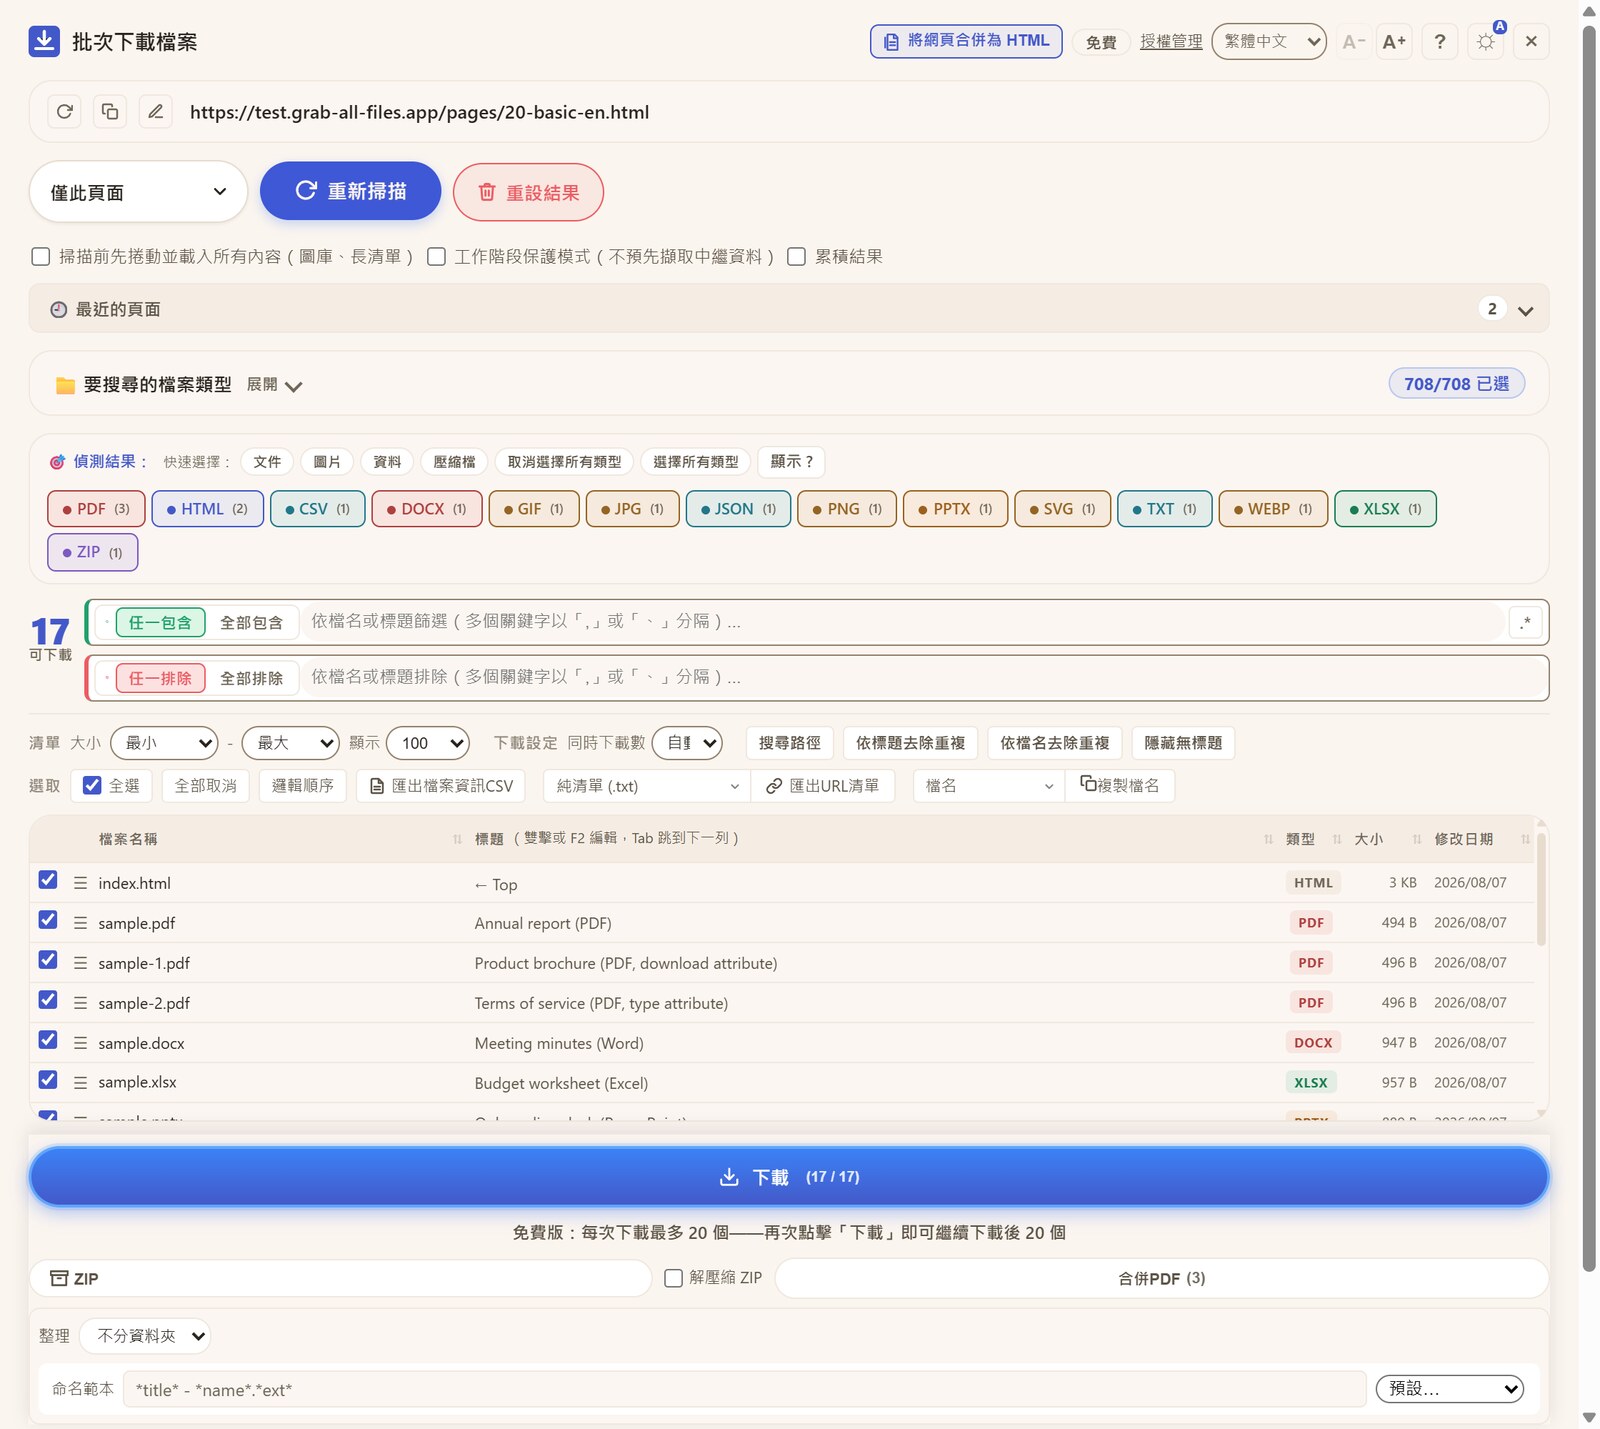
找出頁面上所有可下載的檔案(708 種),一鍵儲存您選取的檔案。
- 可偵測 iframe、閱讀器、延遲載入、fetch/XHR 與 blob URL 背後的檔案
- 合併 PDF、打包 ZIP、匯出 CSV,全部在瀏覽器內完成
- 免費方案每次下載儲存 10 個檔案,重複下載即可儲存其餘檔案
一個擴充功能內含兩項工具。Free 每次可批次儲存最多 10 個檔案,並尋找相關頁面候選,讓您選擇其中 1 頁儲存為 HTML。所選頁面內的圖片與直接連結檔案不受方案數量限制。Pro 可解除檔案上限,並將多個所選頁面正文合併成一個可搜尋的 HTML。仍適用安全上限與來源網站限制;所有處理皆在裝置上完成。
正在使用手機或平板? 此擴充功能可安裝在電腦版 Chrome、Edge 或 Firefox。請在電腦上開啟本頁面進行安裝。
在瀏覽器中下載 Grab All Files: 下載 Chrome 版 下載 Edge 版 下載 Firefox 版兩者都包含在免費方案中,可在擴充功能內的同一標籤列切換。
找出頁面上所有可下載的檔案(708 種),一鍵儲存您選取的檔案。
從您開啟的頁面出發,尋找相關頁面,並將所選頁面合併為一個附目錄、可搜尋的 HTML 檔案。
確認 GrabAllFiles 中的舊檔案後,可讓 Firefox 自動將頁面加入同一個 HTML。連結文件會分別儲存。
為從多個網頁收集文件的使用者設計 — 研究人員、檔案管理員、內部入口網站使用者、設計師和學生。
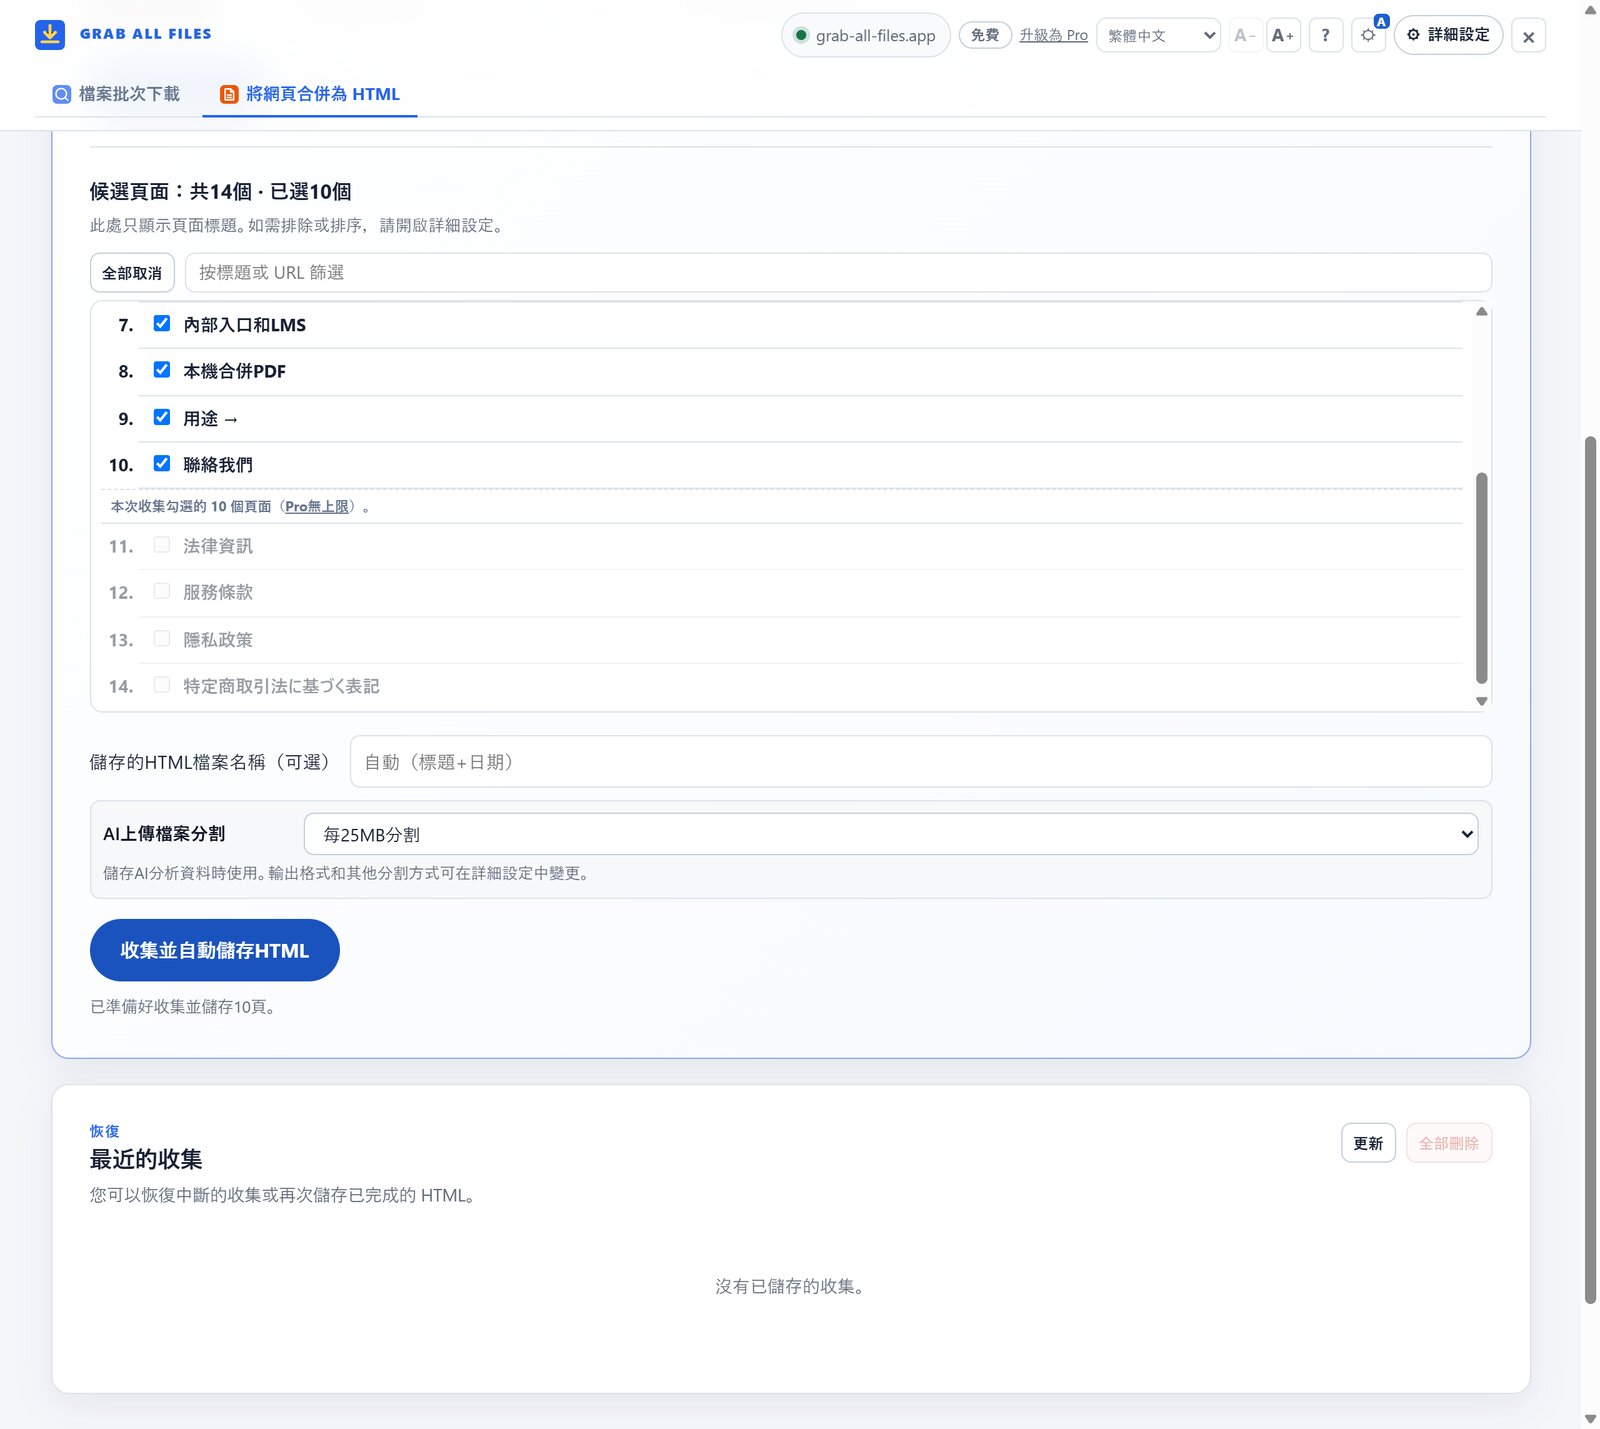
從瀏覽器目前開啟的頁面開始。Grab All Files 會尋找相關頁面,讓您檢視將收錄的內容,並將所選頁面合併成一個附有目錄、可搜尋且可列印的 HTML 檔案。
可使用自動探索快速開始,也可透過詳細設定指定選單、路徑、網站地圖和貼上的 URL 清單。收集前可檢查頁面標題,並移除不需要的頁面或調整順序。
可嵌入圖片以供離線閱讀,也可保留線上參照以縮小檔案。連結的 PDF、Office 檔案及其他文件也可與 HTML 一併儲存。
可產生來源可追溯的 Markdown、JSONL、manifest 和表格資料以供分析。頁面收集和 HTML 產生均在您的裝置本機執行;頁面內容不會上傳至我們的伺服器。
Free 可尋找並列出相關候選頁面,再儲存您選擇的 1 頁。該頁內的圖片與直接連結檔案不受方案數量限制。Pro 可選擇多個候選頁面並將其正文合併成一個 HTML。兩種方案皆適用安全上限與來源網站限制。
查看如何將多個網頁合併成一個 HTML →支援 708 種檔案類型(副檔名)。偵測iframe內的PDF、延遲載入圖片、fetch/XHR回應、blob URL、CMS下載路徑及39種data-*屬性。更能深入 Shadow DOM / Web Components、SPA 水合資料(Next.js、JSON-LD)、Cache Storage / OPFS / IndexedDB 以及帶簽章的雲端儲存 URL(Cloudflare R2、Firebase、Supabase、Vercel Blob)。
依副檔名、大小、名稱、日期篩選。排序、手動重新排序、將URL複製為純文字。
選擇深度(0–5或無限)造訪起始頁所在資料夾下的連結(從網站根目錄開始可涵蓋整站)。每次執行最多100,000頁。還會讀取 sitemap.xml / robots.txt,並跟隨 JavaScript 選單(javascript:/onclick)、框架集、影像地圖與 GET 搜尋/分頁表單中的連結,到達沒有普通 HTML 連結的頁面。
將選取的PDF合併為單一檔案。無需上傳、無需伺服器。檔案保留在您的裝置上。
將選取的檔案封存為單一ZIP — 完全在瀏覽器中產生。
將URL、名稱、大小、類型和標題匯出為CSV,用於文件、稽核或自動化。
使用您目前的瀏覽器工作階段,檢查您已獲授權開啟的內網、LMS/入口網站和會員頁面。不收集憑證,也不繞過存取控制。
在你已獲授權存取的頁面內,可處理 JavaScript 算繪的 SPA(React、Next、Nuxt、Vue)、檢視器路徑以及受 CSRF 保護的表單。檔案類型會透過簽章確認,而不只依賴副檔名;也可以掃描舊的 HTTP 網站。
一次掃描多個網址或爬取整個網站,再控制並行下載數、暫停/繼續、失敗自動重試、依類型或網域歸入子資料夾,並用 PDF 標題重新命名檔案。
Grab All Files 專注兩項工作:在複雜或需登入的頁面中尋找檔案,以及將所選多個頁面整理成一個易讀的HTML。下載管理器與整站複製工具負責流程中的其他部分。
隱藏在 iframe、檢視器、JavaScript、登入和 CMS 路徑之後的 PDF、圖片和文件。Grab All Files 會偵測它們,支援篩選和選擇,然後在本機一鍵批次下載、合併 PDF、產生 ZIP 並匯出 CSV。這正是 Grab All Files 的專長。
對於超大檔案,或需要佇列管理與續傳的長時間無人看管批次任務,專用下載管理器(JDownloader、aria2)更合適。Grab All Files 負責發現檔案並匯出 URL 清單,繁重下載交給它。
如果您需要保留原始頁面、連結和結構且可正常瀏覽的複本,請使用 HTTrack 等網站複製工具。Grab All Files 則是將所選頁面中便於閱讀的內容合併成一個附有目錄的 HTML 檔案,並不會建立像素級還原的網站複本。
從市、縣、中央機構網站批次下載PDF報告、申請表和公開資料。
收集分散在教師頁面和知識庫中的論文、課程教材和資料集。
從企業內網、學習管理系統(Moodle、Canvas、Blackboard)和會員網站擷取附件。
儲存圖片庫、資料集供離線查閱。
依目標選擇工具,無需帳戶,也不會上傳頁面內容。
使用目前分頁或貼上URL。選擇爬取深度:僅此頁面、1–5層或無限。
結果顯示檔案名稱、類型、大小、標題和URL。儲存前可篩選、排序、搜尋。
批次下載至所選資料夾、封存為ZIP,或合併PDF — 全部在本機完成。
使用自動尋找,或透過選單、路徑、網站地圖與URL清單精確指定頁面。
Free始終只選擇1個候選頁面;Pro可選擇並排序多個候選。然後選擇圖片與直接連結檔案選項。
Free儲存所選1個頁面;Pro將多個頁面正文合併成附統一目錄、可搜尋的HTML。AI資料可依預設25MB或指定大小分割。
Free
Pro
兩種方案皆在裝置上處理頁面內容。仍適用安全、身分驗證、權限、來源網站與裝置保護限制。
檔案直接從來源網站下載到您的電腦。只有授權驗證和選用的假名化使用統計會到達我們的伺服器。使用統計預設關閉,僅在明確同意後傳送。
Stripe付款。無訂閱,無自動續費。授權金鑰電子郵件寄送。
EN / JA / ES / FR / DE / IT / KO / PT-BR / ZH-CN / ZH-TW。重複使用瀏覽器登入工作階段——在受保護的入口網站上也可使用。
Grab All Files 支援 708 種檔案類型(副檔名),包括 PDF、Word、Excel、PowerPoint、圖片、ZIP 和 CSV。也能偵測分卷 / 多卷壓縮檔序列(.000/.001…、WinRAR .r00/.s00、WinZip .z01)並歸入壓縮檔類別。可依副檔名篩選,選擇所需檔案,一鍵全部下載。
可以。Free 每次最多批次儲存 10 個檔案,並尋找相關候選頁面,讓您始終只選 1 頁儲存為 HTML。所選頁面內圖片與直接連結檔案不受方案數量限制,但仍適用安全上限與來源網站限制。Pro 為 $19.99 一次購買,可解除檔案上限並將多個頁面正文合併成一個 HTML。
可以,Pro 支援此功能。Free 也會尋找並列出相關候選頁面,但只儲存您選擇的 1 頁。Pro 可選擇多個候選頁面,將其可讀正文合併成附統一目錄、可搜尋、可列印的一個 HTML。
$19.99 USD 一次性購買。永久授權,無訂閱。最多3台裝置。
不會。檔案直接從來源網站下載到您的裝置。只有授權驗證和預設關閉且僅在明確同意後傳送的選用假名化使用統計會到達我們的伺服器,絕不包含頁面內容、URL或檔案名稱。
Google Chrome 和 Microsoft Edge(Chromium 111 或更新版本),以及 Mozilla Firefox(128 或更新版本)。
作為立即交付的數位產品,原則上不接受退款。購買 Pro 前,可用 Free 確認相容性並試用單頁 HTML 與每次 10 個檔案的下載流程。若技術故障導致無法使用,請在 30 天內聯絡我們以獲得全額退款。
可以。Grab All Files 內建下載管理器,支援並行數調整、暫停/續傳、自動重試以及一鍵重試失敗檔案,即使斷線也能讓大批量任務繼續。對於數GB的單一檔案或長時間無人看管的任務,您也可以匯出URL清單,交給專用下載管理器。
可以,兩者互補。Grab All Files 擅長在複雜或需登入的頁面上發現檔案(隱藏於 iframe、檢視器、JavaScript 與 CMS 路徑之後)。將結果匯出為 CSV 或URL清單,交給下載管理器進行大批量下載即可:發現交給 Grab All Files,繁重下載交給下載管理器。
可以。它會在頁面建構後讀取 JavaScript 渲染的單頁應用(React、Next.js、Nuxt、Vue),在您已可開啟的頁面上使用您現有的瀏覽器工作階段,跟隨受 CSRF 保護的下載表單,並偵測 Cloudflare/WAF 機器人牆以引導復原。它透過檔案簽章而非僅憑副檔名確認檔案類型,且絕不繞過存取控制或安全防護。
Free 每次最多儲存 10 個檔案,並將所選 1 頁儲存為 HTML。Pro 可解除檔案上限並將多個頁面正文合併成一個 HTML。