
 ツール 1
ファイル一括ダウンロード
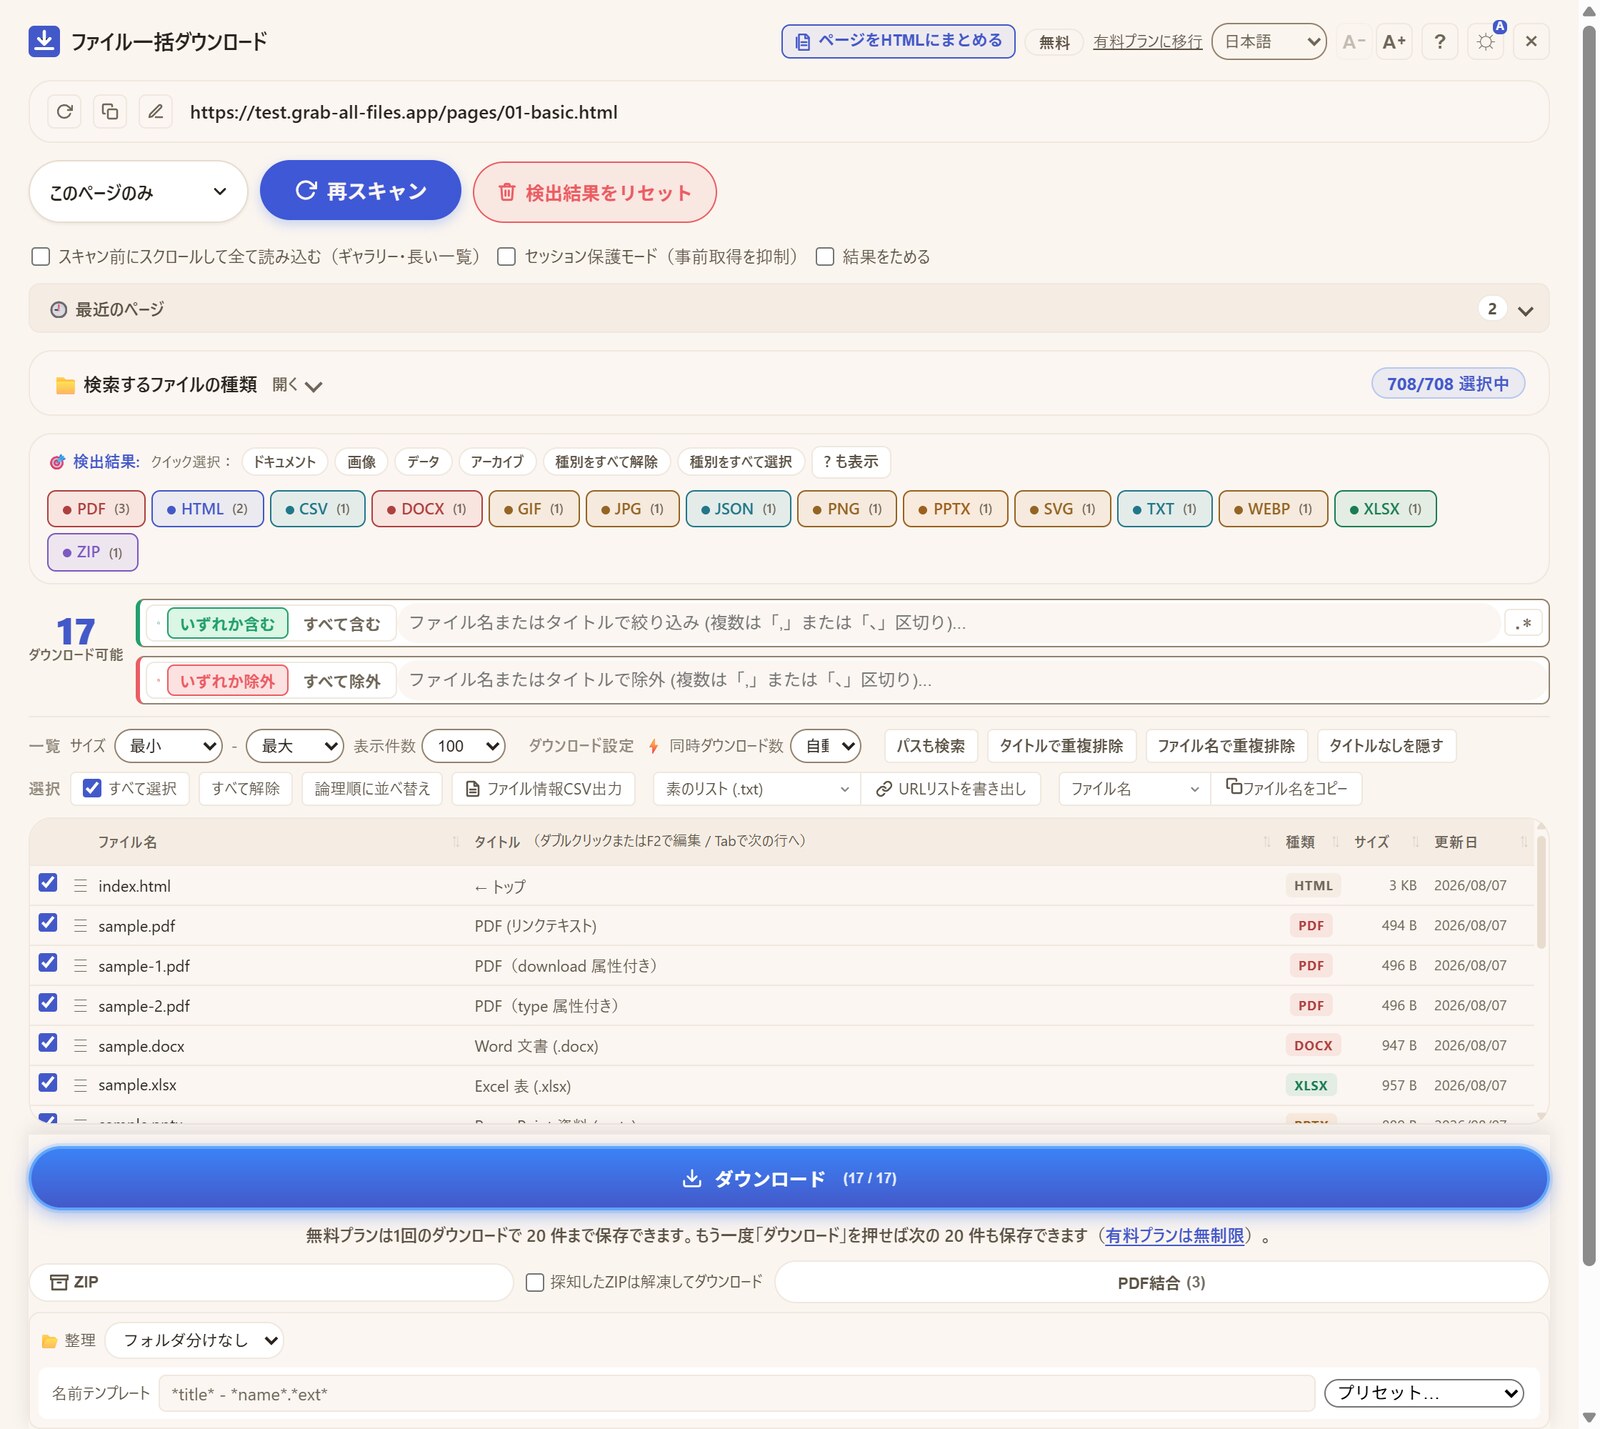
ページ上のダウンロード可能なファイル(708種類)を検出し、選んだものを1クリックでまとめて保存します。
- iframe・PDFビューア・遅延読み込み・fetch/XHR・blob URL の奥にあるファイルも検出
- PDF結合、ZIP作成、CSV出力まで、すべてブラウザ内で完結
- 無料プランは1回のダウンロードで10件まで。次のファイルを選んで、もう一度「選んだファイルを保存」を押せば続きも保存できます
Grab All Files は、2つのツールを備えたブラウザ拡張機能です。ファイル一括ダウンロードはページ上のPDF・画像・Office文書・ZIPなどを見つけ、チェックしたものをまとめて保存します。ページをHTMLにまとめるはWebページを検索できる1つのHTMLに保存します(Proなら関連する複数ページを1つに)。無料版:ファイルは1回のダウンロードで10件まで、ページは1回1ページ。Pro($19.99の買い切り):ファイル上限なし・複数ページ結合。処理はすべて端末内で行います。
スマートフォン・タブレットでご覧の方へ 拡張機能はPCの Chrome・Edge・Firefox に追加できます。PCでこのページを開いてインストールしてください。
お使いのブラウザで Grab All Files をダウンロード: Chrome 用をダウンロード Edge 用をダウンロード Firefox 用をダウンロードどちらも無料プランに含まれ、拡張機能内の同じタブから切り替えて使えます。
ツール 1ページ上のダウンロード可能なファイル(708種類)を検出し、選んだものを1クリックでまとめて保存します。
 ツール 2
開いているページを起点に関連ページを探し、選んだページを目次つきの検索できるHTML 1ファイルにまとめます。
右上「⋯」メニューの項目を「Pro・ライセンスキー」に変え、購入メールと購入完了ページでキー入力欄までの手順を具体的に案内します。保存したHTMLの検索バーに「配色」ボタン(自動・ライト・ダーク)が加わり、「元の見た目のまま」はパソコンのフォルダに加えてWebページの収集でも選べます。
複数ページから資料を集める人のためのツールです。調査・研究、自治体・大学公開資料の収集、社内ポータル業務、デザイン素材集め、論文・教材ダウンロードなど、「保存」を何度も押す手間を減らします。
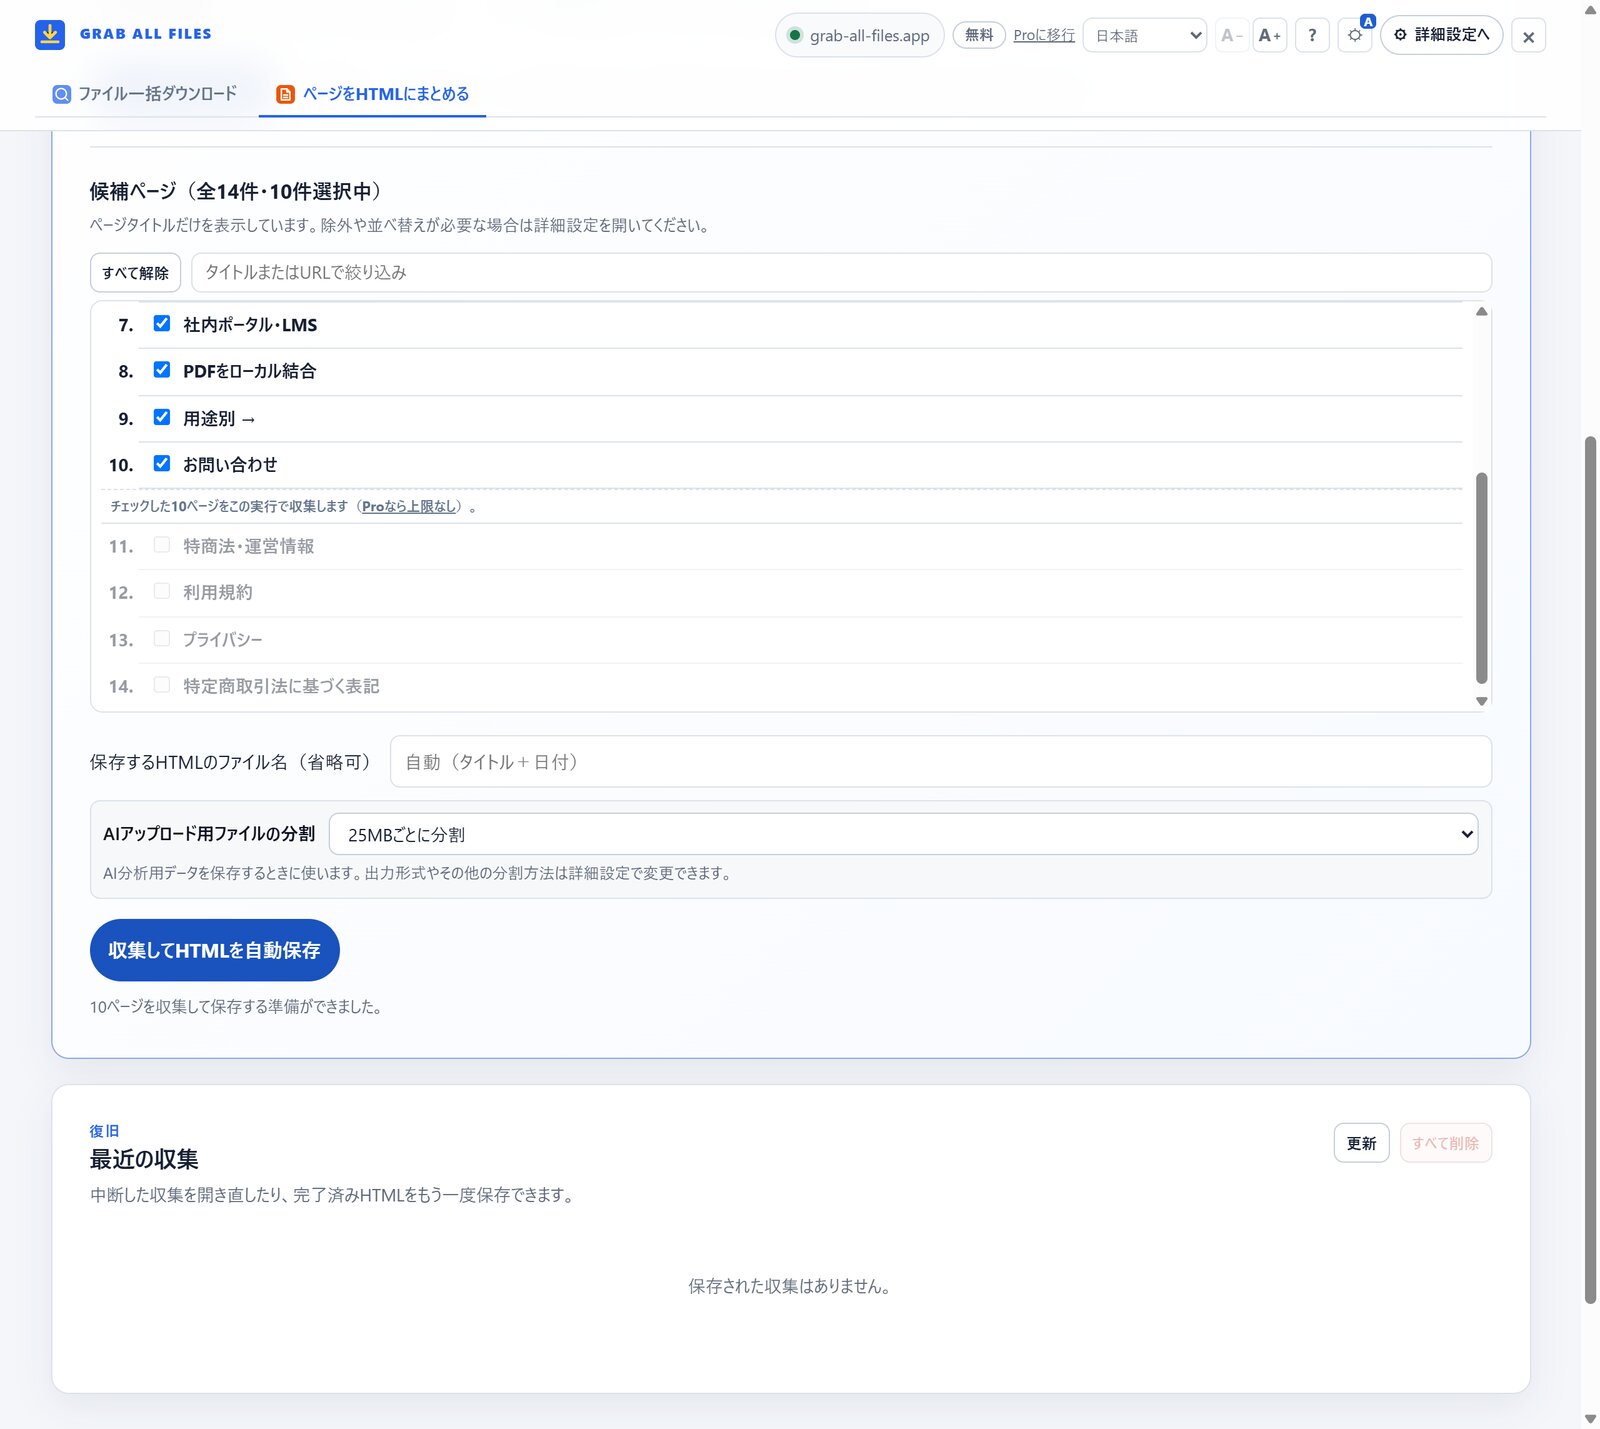
ブラウザで開いているページを起点に、関連ページを探索。収録するページを確認・選択し、目次付きで検索・印刷できる1つのHTMLにまとめます。
すぐ使える自動探索に加え、メニュー・パス・sitemap・URLリストを指定する詳細設定にも対応。収集前にタイトルを確認し、不要なページの除外や並べ替えができます。
画像を埋め込んでオフライン閲覧、またはオンライン参照で軽量化。リンク先のPDF・Office文書などもHTMLと一緒に保存できます。
出典付きMarkdown、JSONL、manifest、表データを生成可能。ページ収集とHTML生成は端末内で処理し、ページ内容を当社サーバーへアップロードしません。
無料版は関連候補を探索・一覧表示し、選んだ1ページを保存します。そのページ内の画像にはプラン上の件数制限がありません。直接リンクされたファイルは1回10件までで、結果画面の「次の10件を保存」で続けて保存できます。Proは複数候補の本文を1つのHTMLに結合します。どちらも安全上限・サイト側制限が適用されます。
複数ページを1つのHTMLにまとめる手順を見る →708種類(拡張子)のファイルに対応。iframe内のPDF、遅延読み込み画像、fetch/XHRで取得されるファイル、blob URL、CMSダウンロードルート、hidden inputの値、39種類のdata-*属性まで網羅。通常のリンクスクレイパーでは拾えないファイルも検出します。さらにShadow DOM/Web Components内、SPAのハイドレーションデータ(Next.js・JSON-LD)、Cache Storage/OPFS/IndexedDB、署名付きクラウドストレージURL(Cloudflare R2・Firebase・Supabase・Vercel Blob)にも対応します。
拡張子、ファイルサイズ、ファイル名、ページタイトル、更新日で絞り込み・並べ替え・手動並べ替え。URLのプレーンテキストコピーにも対応。
深度0〜5または無制限を選んで、起点ページのフォルダー配下のリンク先を巡回(サイト全体を対象にするにはサイトのルートから開始)。サブページに散らばったPDF、ビューアURL、CMS文書ルートまで一気に収集。1回の実行で最大10万ページまで。さらに sitemap.xml/robots.txt を解析し、JavaScriptメニュー(javascript:/onclick)・フレームセット・イメージマップ・GET検索/ページャのリンクも辿るので、通常の<a>リンクが無いページにも到達します。
選択したPDFを1つにまとめます。アップロード不要・サーバー送信なし。ファイルは端末から外に出ません。
選択したファイルを1つのZIPにまとめて配布・アーカイブ・共有しやすく。ブラウザ内ですべて完結します。
URL、ファイル名、サイズ、種類、タイトルをCSV出力。資料台帳、棚卸し、報告書、後続の自動処理にそのまま使えます。
お使いのブラウザのセッションを利用し、すでに正当に開ける社内ポータル、LMS、会員ページ内の資料を確認できます。認証情報を収集したり、アクセス制御を回避したりするものではありません。
正当にアクセスできるページ内であれば、JavaScript描画のSPA(React・Next・Nuxt・Vue)、ビューア経由のURL、CSRF保護フォームなど、通常のダウンローダーが取りこぼす経路も確認します。種別は拡張子だけでなくバイト署名でも判定し、HTTP(非HTTPS)の旧サイトもスキャンできます。
複数URLを一度にスキャン、またはサイト全体をクロール。並列数の調整、一時停止/再開、失敗の自動リトライ、種類別・ドメイン別のフォルダ仕分け、PDFタイトルからのファイル名変更まで。
Grab All Files は、複雑・ログイン必須ページからファイルを見つけることと、選んだ複数ページを読みやすい1つのHTMLにまとめることに特化しています。ダウンロードマネージャやサイト複製ツールとは役割が異なります。
iframe・ビューア・JavaScript・ログイン・CMSルートの奥に隠れたPDF・画像・文書。Grab All Files が検出し、絞り込み・選択のうえ、一括ダウンロード・PDF結合・ZIP化・CSV出力までローカルで完結します。
数GBのファイルや、キュー管理・再開が必要な長時間の無人バッチには、専用のダウンロードマネージャ(JDownloader、aria2)が最適です。Grab All Files でファイルを発見してURLリストを書き出し、重いダウンロードはそちらに任せましょう。
元のページ・リンク・構造を保った閲覧可能な複製には、HTTrack などのサイト複製ツールが適しています。Grab All Files は、選択したページの読みやすい本文を目次付きの1つのHTMLにまとめる機能で、見た目まで同一のサイト複製ではありません。
市区町村・都道府県・省庁のサイトから報告書PDF、申請書、公開資料をまとめてダウンロード。
各教員ページや論文リポジトリに分散した論文・講義資料・実験レポート・データセットを一括取得。
イントラネット、学習管理システム(Moodle、Canvas、Blackboard)、会員サイトの添付資料をまとめて保存。
画像ギャラリー、データセット、CSV出力をオフライン閲覧・後処理用に一括保存。
目的に合う機能を選ぶだけ。アカウント登録やページ内容のアップロードは不要です。
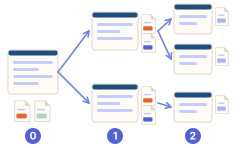
現在のタブを使うか、ポップアップにURLを貼り付け。クロール深度を「このページのみ」「同一サイト内1〜5段」「無制限」から選びます(1回の実行で最大10万ページ)。
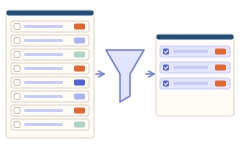
ファイル名、種類、サイズ、ページタイトル、ソースURLを確認できます。保存前に絞り込み・並べ替え・検索・手動並べ替えが可能。
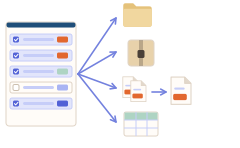
指定フォルダへ一括保存(種類別・ドメイン別整理オプションあり)、ZIPにまとめる、選択したPDFを1つに結合。すべてブラウザ内で完結します。
「ページをHTMLにまとめる」へ切り替え、自動探索またはメニュー・パス・サイトマップ・URL一覧で対象を探します。
無料版は常に1ページだけを選択。Proは複数候補を選択・並べ替えできます。続けて画像と直接リンクされたファイルの保存方法を選びます。
無料版は選んだ1ページ、Proは複数ページ本文を共通目次付きの1つのHTMLに結合。出典付きAIデータは既定25MBまたは指定サイズで分割できます。
ページ収集の選択肢には、どれも絵が付いています。ここに並べたのは拡張機能のカードそのもので、名前も画面の表示と同じです。




無料版は1回につき、選んだ1ページを保存します。複数のページを1つのHTMLにまとめるのはProの機能です。
無料版
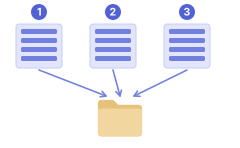
Pro
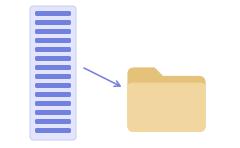
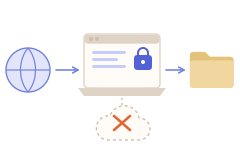 両プランともページ内容は端末内で処理します。安全上限・認証・権限・サイト側・端末保護上の制限は適用されます。
ファイルはサイトから直接お使いのPCへ。サーバーに届くのはライセンス認証と任意の仮名化利用統計だけです。利用統計は初期設定でオフであり、明示的な同意後にのみ送信されます。
Stripe決済。サブスクなし・自動更新なし。永続ライセンスで、1つのキーを最大3台で使えます。キーは決済直後の画面とメールでお届けします。無料版に期限はありません。
EN/JA/ES/FR/DE/IT/KO/PT-BR/ZH-CN/ZH-TW。ブラウザのログイン状態をそのまま使うので、社内ポータルにも対応。
708種類(拡張子)のファイルに対応しています(PDF・Word・Excel・PowerPoint・画像・ZIP・CSVなど)。分割・マルチボリュームアーカイブ(.000/.001…、WinRAR .r00/.s00、WinZip .z01)も検出し、圧縮アーカイブとして分類します。拡張子で絞り込み、必要なものを選んでワンクリックで一括ダウンロードできます。
はい。無料版はファイルを1回のダウンロードで10件まで一括保存でき、関連ページを探して候補から常に1ページだけ選んでHTML保存できます。選んだページ内の画像にはプラン上の件数制限がなく、直接リンクされたファイルは10件ずつ保存します(結果画面の「次の10件を保存」で続きを保存)。安全上限・サイト側制限は適用されます。Proは$19.99の買い切りで、ファイル上限を解除し、選んだ複数ページの本文を1つのHTMLに結合します。
何もロックされません。無料版は1回のダウンロードで10件まで保存します。保存が終わったら、一覧で次のファイルを選んで、もう一度「選んだファイルを保存」を押してください。繰り返せば残りも保存できます。Proには1回あたりの上限がありません。
はい、Proで利用できます。無料版でも関連候補を探索・一覧表示できますが、HTML保存するのは選んだ1ページです。Proでは複数候補を選び、各ページの読みやすい本文を共通目次付きで検索・印刷できる1つのHTMLにまとめます。
$19.99 USDの買い切りで、永続ライセンス(サブスクなし)です。最大3台で利用できます(1台=1台のパソコン上のブラウザープロファイル1つ)。拡張機能のライセンス画面から端末を解除すれば、その枠を別の端末で使えます。
ライセンスキーは決済直後の購入完了ページに表示され、メールでも届きます。拡張機能を開き、右上の「無料」(または「⋯」メニュー →「Pro・ライセンスキー」)から入力欄を開いてキーを貼り付け、「有効化」を押してください。右上の表示が「Pro」に変われば完了です。
いいえ。ファイルはソースサイトから端末へ直接ダウンロードされます。当社サーバーへ送信されるのはライセンス検証と、任意の仮名化利用統計だけです。利用統計は初期設定でオフで、明示的に同意した後にだけ送信され、内容はランダムなインストールID、拡張機能のバージョン、プラン、件数などの大まかな数値やラベル(例:見つかったファイル数)に限られます。ページ内容・URL・ファイル名は一切送信しません。詳しくはセキュリティと権限をご覧ください。
Google Chrome および Microsoft Edge(Chromium 111 以降)、および Mozilla Firefox(128 以降)。
即時提供のデジタル製品のため、原則として返金には応じておりません。無料版で互換性と1ページHTML保存・1回10件のファイル保存を確認してからProをご購入いただけます。技術的な不具合により動作しない場合は、購入日から30日以内にお問い合わせフォームからご連絡いただければ全額返金いたします。
はい。お使いのブラウザのセッションを利用し、社内ポータル、LMS、会員ページなど、すでに正当にアクセスできるページをスキャンできます。認証情報を収集したり、アクセス制御を回避したりするものではありません。
Grab All Files を Google Chrome、Microsoft Edge、または Mozilla Firefox にインストールし、対象ページを開く(またはURLを貼り付ける)だけで、iframe、ビューア、遅延読み込み、fetch/XHR、blob URL、CMSダウンロードルートに隠れたファイルまで含めて検出・一覧表示します。必要なファイルを選んでワンクリックで一括保存できます。
iframe埋め込みPDFやPDFビューアのURLも含めてページ上のPDFを検出し、同一サイト内を1回の実行で最大10万ページまでクロールできます。PDFで絞り込んで全選択し、一括ダウンロード、またはブラウザ内で1つのPDFに結合できます。
Grab All Files は Google Chrome・Microsoft Edge・Mozilla Firefox 向けのファイル一括ダウンロード拡張機能です。通常のリンク抽出では見落としがちなPDF・Office文書・画像・ZIP・CSVを検出し、選んだファイルをワンクリックで保存、PDF結合、ZIP作成、ファイルURLのCSV出力ができます。無料版は1回のダウンロードで10件まで(繰り返して続きを保存可能)、$19.99の買い切りのProで1回あたりの上限を解除できます。
遅延読み込み画像、CSS背景画像、blob URLも含めて画像を検出します。画像種別で絞り込んで選択し、一括ダウンロード、または画像URLの一覧をCSV出力できます。
はい。選択したPDFはブラウザ内(ローカル)で結合されます。アップロードは一切なく、ファイルが端末の外に出ることはありません。
はい。Grab All Files はビルトインのダウンロードマネージャを備え、並列数の調整・一時停止/再開・自動リトライ・失敗分のみのワンクリック再試行に対応します。回線が切れても大量のバッチを継続できます。数GBの単一ファイルや長時間の無人ジョブは、URLリストを書き出して専用のダウンロードマネージャに渡すこともできます。
はい。互いに補完します。Grab All Files は、iframe・ビューア・JavaScript・CMSルートの奥にあるファイルなど、複雑なページやログイン必須ページでの「発見」が得意です。結果を CSV や URL リストとして書き出し、専用のダウンロードマネージャに渡せば大量の一括ダウンロードを任せられます。発見は Grab All Files、重いダウンロードは専用のダウンロードマネージャ、という役割分担です。
はい。React・Next.js・Nuxt・Vue などの JavaScript 描画後のSPAを読み取り、すでに正当にアクセスできるページではお使いのブラウザセッションを利用します。CSRF保護されたダウンロードフォームにも追従し、Cloudflare/WAF のボット対策を検出して回復を案内します。拡張子だけでなく署名(マジックバイト)でファイル種別を確認します。アクセス制御やセキュリティ保護を回避することはありません。
無料版はファイルを1回のダウンロードにつき10件まで保存し、候補から選んだ1ページをHTML保存。Proはファイル上限を解除し、複数ページの本文を1つのHTMLに結合します。