
 工具 1
文件批量下载
找出页面上所有可下载的文件(708 种),保存您选中的文件。
- 可检测 iframe、查看器、懒加载、fetch/XHR 和 blob URL 背后的文件
- 合并 PDF、打包 ZIP、导出 CSV,全部在浏览器内完成
- 免费版每次下载最多保存 10 个文件,选择接下来的文件并再次点击“保存所选文件”即可保存其余文件
Grab All Files 是一款内含两项工具的浏览器扩展。文件批量下载可找出页面上可下载的 PDF、图片、Office 文档、ZIP 等文件,并一次保存您勾选的文件。将网页合并为 HTML可将网页保存为一个可搜索的 HTML(Pro 可将多个相关页面合为一个)。免费版:每次下载最多 10 个文件,每次运行保存 1 个页面。Pro($19.99 一次购买):无文件上限,可合并多个页面。所有处理均在您的设备上完成。
正在使用手机或平板? 此扩展可安装在电脑版 Chrome、Edge 或 Firefox 上。请在电脑上打开本页面进行安装。
在浏览器中下载 Grab All Files: 下载 Chrome 版 下载 Edge 版 下载 Firefox 版两者都包含在免费版中,可在扩展内的同一标签栏切换。
工具 1找出页面上所有可下载的文件(708 种),保存您选中的文件。
 工具 2
从您打开的页面出发,查找相关页面,并将所选页面合并为一个带目录、可搜索的 HTML 文件。
“⋯”菜单中的项目已改为“Pro·授权密钥”,购买邮件和购买完成页面会一步步引导您找到密钥输入框。保存的 HTML 在搜索栏新增“配色”按钮(自动、浅色、深色),“保持原样”除本地文件夹外,现在也可用于收集网页。
专为需要从大量网页收集文档的人设计,如研究人员、公开资料归档人员、内部门户用户、设计师、学生,以及所有厌倦了上百次点击“另存为…”的人。
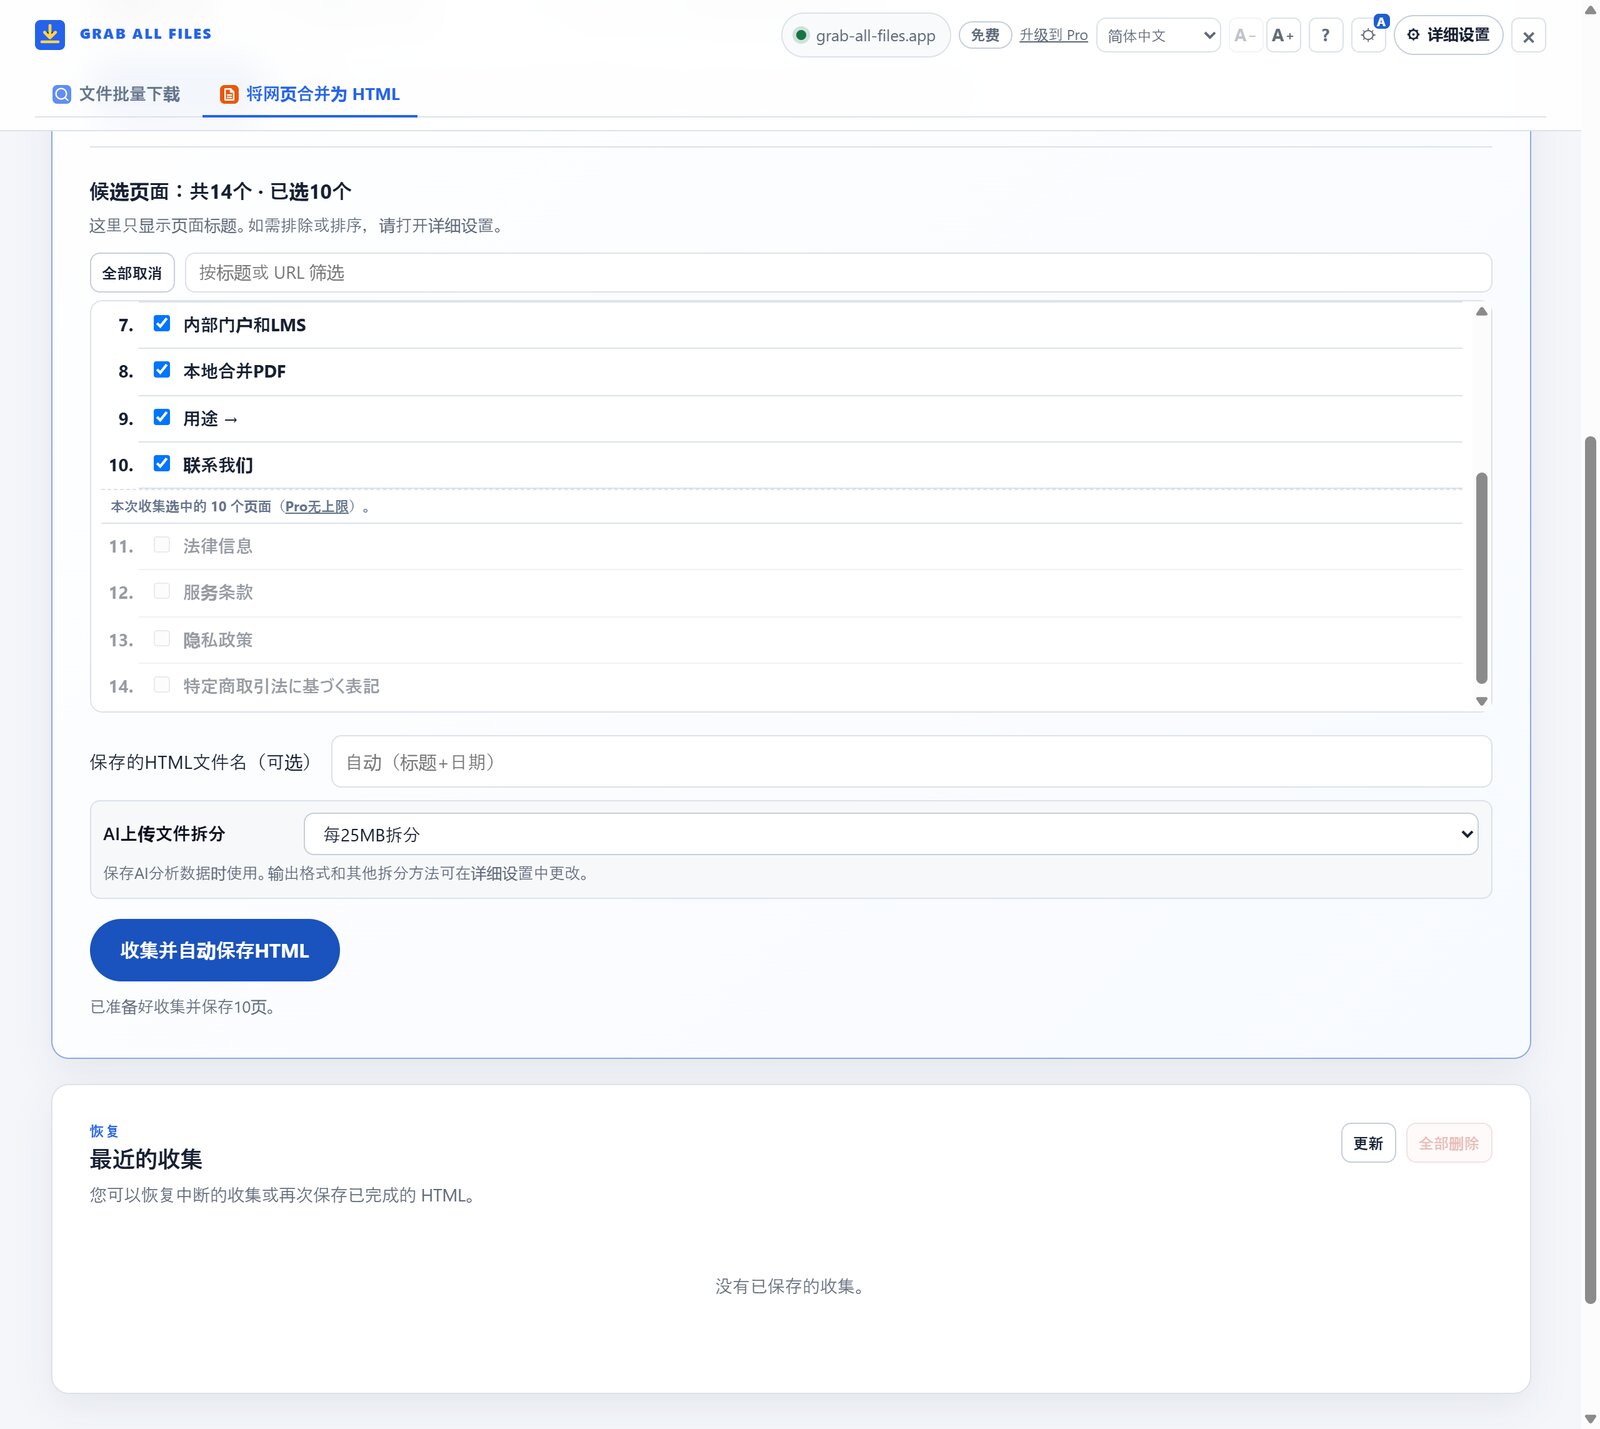
从浏览器中当前打开的页面开始。Grab All Files 会查找相关页面,让您检查将要收录的内容,并将所选页面合并为一个带目录、可搜索、可打印的 HTML 文件。
可使用自动发现快速开始,也可通过详细设置指定菜单、路径、站点地图和粘贴的 URL 列表。收集前可检查页面标题,并删除不需要的页面或调整顺序。
可嵌入图片以便离线阅读,也可保留在线引用以减小文件大小。链接的 PDF、Office 文件及其他文档也可与 HTML 一并保存。
可生成来源可追溯的 Markdown、JSONL、manifest 和表格数据,用于分析。页面收集和 HTML 生成均在您的设备本地运行;页面内容不会上传到我们的服务器。
免费版可查找并列出相关候选页面,然后保存您选择的 1 页。该页内的图片不受套餐数量限制;该页直接链接的文件每次保存 10 个,可在结果画面用“保存接下来的10个”继续保存。Pro 可选择多个候选页面并将其正文合并为一个 HTML。两种套餐均适用安全上限和源网站限制。
查看如何将多个网页合并为一个 HTML →支持 708 种文件类型(扩展名)。检测iframe中的PDF、懒加载图片、fetch/XHR响应、blob URL、CMS下载路径、表单隐藏值,以及普通链接抓取工具会忽略的39个data-*属性。还能深入 Shadow DOM / Web Components、SPA 水合数据(Next.js、JSON-LD)、Cache Storage / OPFS / IndexedDB 以及带签名的云存储 URL(Cloudflare R2、Firebase、Supabase、Vercel Blob)。
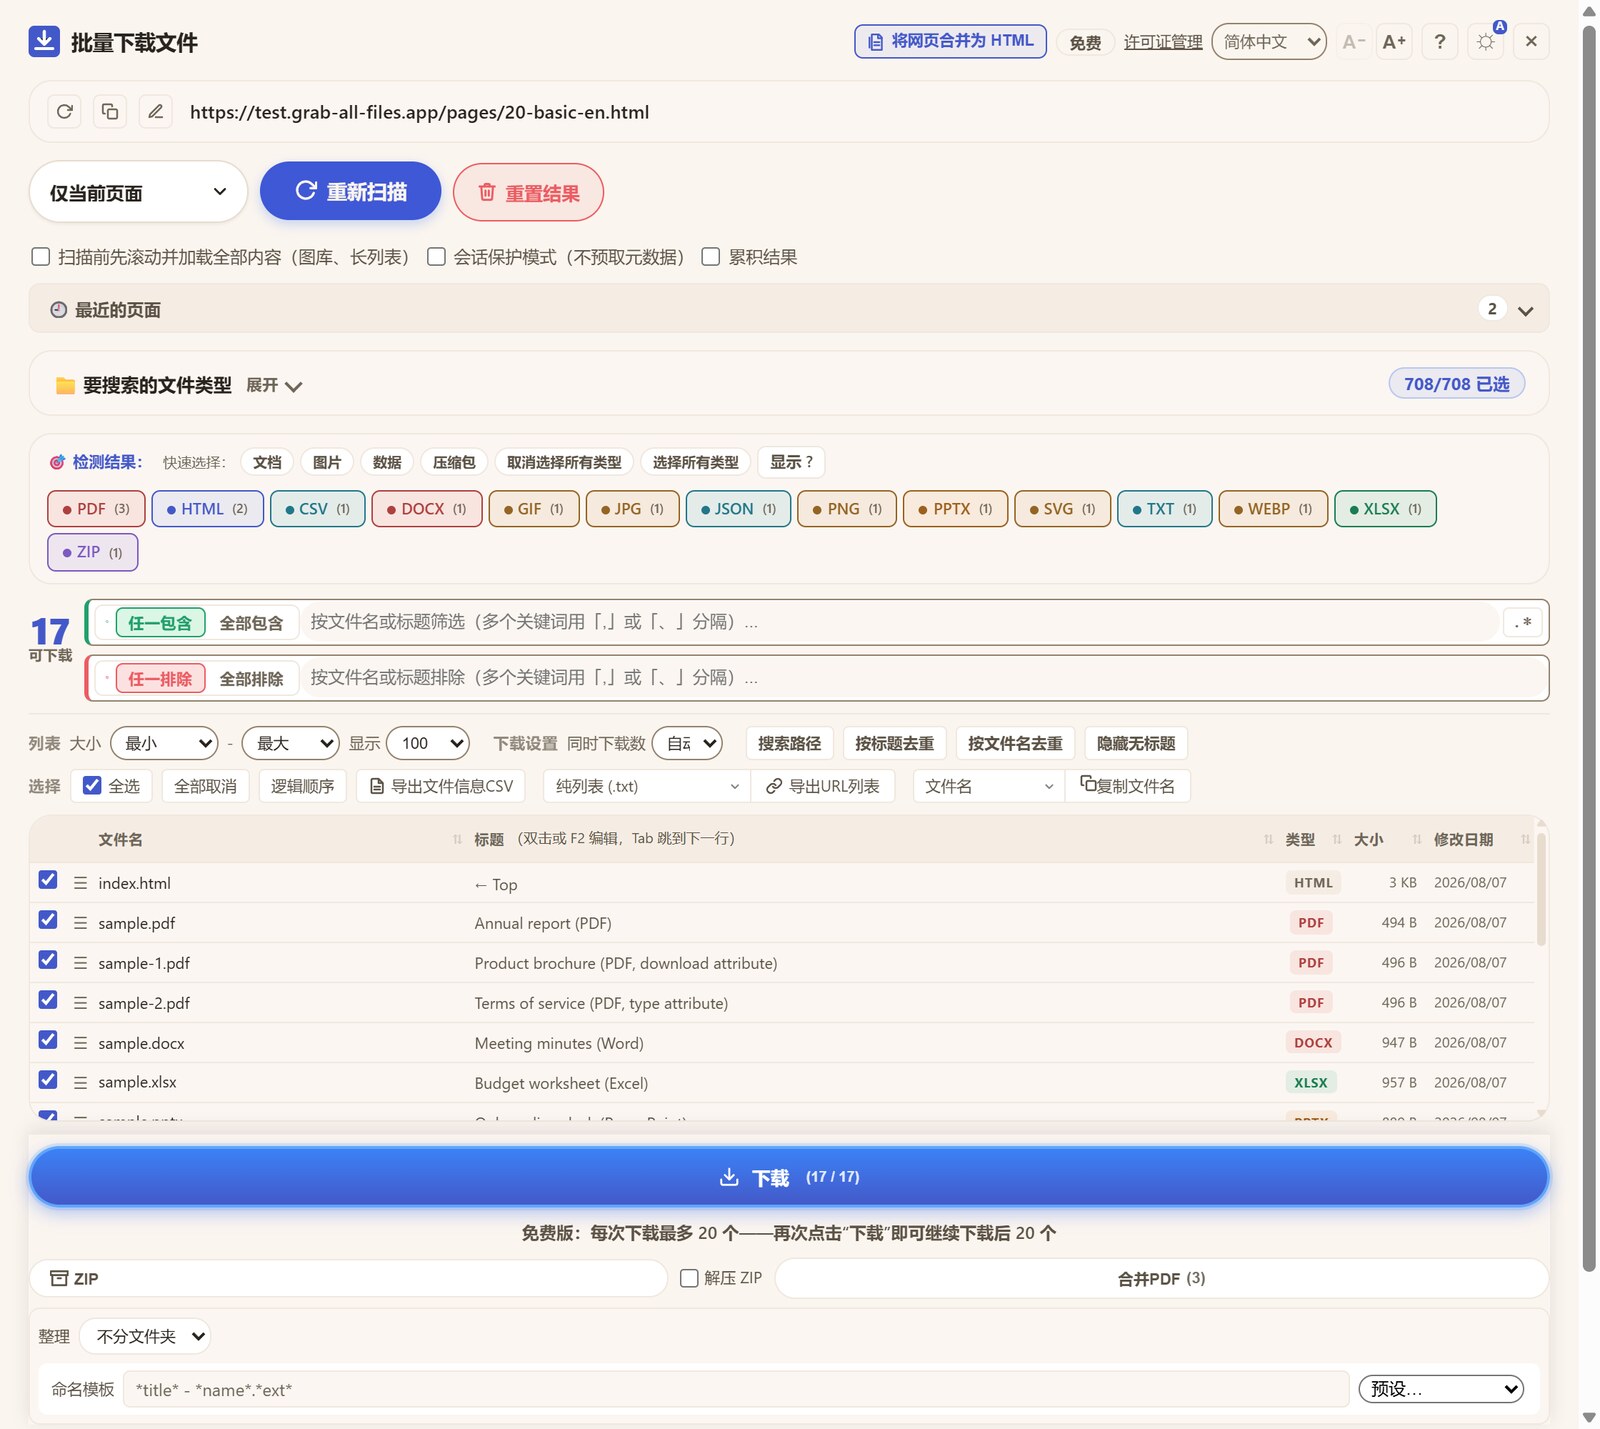
按扩展名、文件大小、文件名、页面标题或修改日期筛选结果。支持排序和手动重排,并可将URL复制为纯文本。
选择深度(0–5或无限)访问起始页所在文件夹下的链接(从站点根目录开始可覆盖整站),找出子页面中的PDF、查看器URL和CMS文档路径,每次运行最多100,000页。还会读取 sitemap.xml / robots.txt,并跟随 JavaScript 菜单(javascript:/onclick)、框架集、图像映射和 GET 搜索/分页表单中的链接,到达没有普通 HTML 链接的页面。
将选定的PDF合并为单个文件。无上传,无服务器。文件保留在您的设备上。
将选定文件打包为单个ZIP,便于分发、归档或共享,完全在浏览器中生成。
将URL、名称、大小、类型和标题导出为CSV,用于文档整理、审计、资料盘点或后续自动化。
使用您当前的浏览器会话,检查您已被授权打开的内网、LMS/门户和会员页面。不收集凭据,也不绕过访问控制。
在您已被授权访问的页面内,可处理 JavaScript 渲染的 SPA(React、Next、Nuxt、Vue)、查看器路径以及受 CSRF 保护的表单。文件类型通过签名确认,而不只依赖扩展名;也可以扫描旧的 HTTP 网站。
一次扫描多个网址或爬取整个网站,再控制并行下载数、暂停/继续、失败自动重试、按类型或域名归入子文件夹,并用 PDF 标题重命名文件。
Grab All Files 专注两项任务:在复杂或需登录的页面中查找文件,以及将所选多个页面整理为一个易读的HTML。下载管理器和整站复制工具负责流程中的其他部分。
隐藏在 iframe、查看器、JavaScript、登录和 CMS 路径之后的 PDF、图片和文档。Grab All Files 会检测它们,支持筛选和选择,然后在本地批量下载、合并 PDF、生成 ZIP 并导出 CSV。
对于超大文件,或需要队列管理与续传的长时间无人值守批量任务,专用下载管理器(JDownloader、aria2)更合适。Grab All Files 负责发现文件并导出 URL 列表,繁重下载交给它。
如果您需要一个保留原始页面、链接和结构且可正常浏览的副本,请使用 HTTrack 等网站复制工具。Grab All Files 则是将所选页面中便于阅读的内容合并为一个带目录的 HTML 文件,并不会创建像素级还原的网站镜像。
从市、省及国家级机关网站批量下载PDF报告、申请表格和公开披露资料。
收集分散在教师主页和资料库中的论文、课程资料、实验报告和数据集文件。
从企业内网、学习管理系统(Moodle、Canvas、Blackboard)和会员网站提取附件。
保存图片库、数据集文件和CSV导出文件,供离线查阅或后续处理。
按目标选择工具,无需账户,也不会上传页面内容。
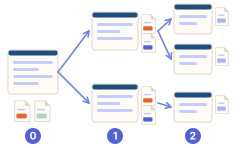
使用当前标签页,或在弹出窗口中粘贴URL。选择爬取深度:仅此页面、同站链接1–5级,或无限(每次运行最多100,000页)。
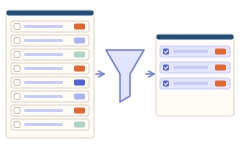
结果显示文件名、类型、大小、页面标题和来源URL。保存前可筛选、排序、搜索和调整顺序。
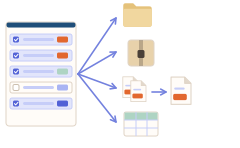
批量下载到您选择的文件夹(可按文件类型或域名分类)、打包为ZIP,或将所选PDF合并为一个,全部在浏览器本地完成。
切换到“将网页合并为 HTML”,然后使用自动查找,或通过菜单、路径、站点地图和粘贴的URL列表详细指定页面。
免费版始终只选择1个候选页面;Pro可选择并排序多个候选。然后选择图片和直接链接文件的选项。
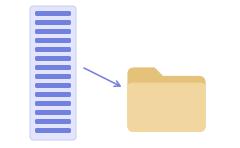
免费版保存所选的1个页面;Pro将多个页面的正文合并为带统一目录、可搜索的HTML。可选的AI数据可按默认25MB或指定大小分割。
页面收集的每个选项都配有图示。这里展示的就是扩展自身的卡片,名称与界面上显示的一致。




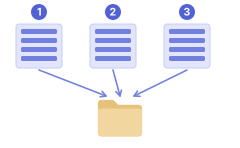
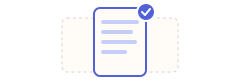
免费版每次保存所选的 1 个页面。将多个页面合并为一个 HTML 是 Pro 功能。
免费版
Pro
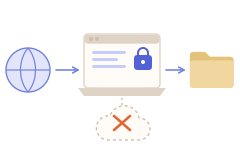 两种套餐均在设备上处理页面内容。仍适用安全、身份验证、权限、源网站及设备保护限制。
文件直接从源网站下载到您的电脑。只有授权验证和可选的假名化使用统计会到达我们的服务器。使用统计默认关闭,仅在明确同意后发送。
Stripe 支付。无订阅,无自动续费。永久授权,一个密钥最多可用于 3 台设备。密钥在付款后立即显示,并通过邮件发送。免费版没有使用期限。
EN / JA / ES / FR / DE / IT / KO / PT-BR / ZH-CN / ZH-TW。复用浏览器登录会话——在受保护的门户上也可使用。
Grab All Files 支持 708 种文件类型(扩展名),包括 PDF、Word、Excel、PowerPoint、图片、ZIP 和 CSV。还能检测分卷 / 多卷压缩包序列(.000/.001…、WinRAR .r00/.s00、WinZip .z01)并归入压缩文件类别。可按扩展名筛选,选择所需文件后即可下载。
可以。免费版每次下载最多批量保存 10 个文件,并查找相关页面,让您始终只选 1 页保存为 HTML。所选页面内的图片不受套餐数量限制;该页直接链接的文件每次保存 10 个,可在结果画面用“保存接下来的10个”继续保存。仍适用安全上限和源网站限制。Pro 为 $19.99 一次购买,可解除文件上限,并将多个页面的正文合并为一个 HTML。
不会锁定任何功能。免费版每次下载最多保存 10 个文件。下载完成后,在列表中选择接下来的文件,再次点击“保存所选文件”即可;重复操作就能保存全部文件。Pro 没有每次下载的数量上限。
可以,Pro 支持此功能。免费版也会查找并列出相关页面,但只保存您选择的 1 页。Pro 可选择多个候选页面,将其可读正文合并为带统一目录、可搜索、可打印的一个 HTML。
$19.99 USD 一次性购买。永久授权,无订阅。最多可在 3 台设备上激活;1 台设备指一台电脑上的一个浏览器配置文件,在扩展的授权界面中移除设备即可腾出名额。
付款后,授权密钥会立即显示在购买完成页面上,并同时通过电子邮件发送给您。打开扩展,点击右上角的“免费”(或打开“⋯”菜单并选择“Pro·授权密钥”),粘贴密钥后点击“激活”。右上角的标签变为“Pro”即表示完成。
不会。文件直接从源网站下载到您的设备。只有授权验证和可选的假名化使用统计会到达我们的服务器。使用统计默认关闭,仅在您明确同意后发送;每条事件只包含随机安装 ID、扩展版本、您的套餐以及粗略的计数或标签(例如找到的文件数),绝不包含页面内容、URL 或文件名。详情请参阅安全和权限。
Google Chrome 和 Microsoft Edge(Chromium 111 或更高版本),以及 Mozilla Firefox(128 或更高版本)。
作为立即交付的数字产品,原则上不接受退款。购买 Pro 前,可用免费版确认兼容性并试用单页 HTML 和每次 10 个文件的下载流程。若技术故障导致无法使用,请在购买之日起 30 天内联系我们以获得全额退款。
可以。扩展会使用您现有的浏览器会话,扫描您已获授权访问的页面,例如内网、LMS 门户和会员专区。它不会收集凭据,也不会绕过访问控制。
为 Google Chrome、Microsoft Edge 或 Mozilla Firefox 安装 Grab All Files,打开页面(或粘贴其 URL),扩展就会列出所有可检测的文件,包括隐藏在 iframe、查看器、懒加载、fetch/XHR 响应、blob URL 和 CMS 下载路径背后的文件。选择所需文件后即可下载。
Grab All Files 能检测页面上的所有 PDF,包括嵌入 iframe 的 PDF 和 PDF 查看器 URL,并可爬取同站点链接,每次运行最多 100,000 页。将结果筛选为 PDF,全选后批量下载,或在浏览器中本地合并为一个 PDF。
Grab All Files 是适用于 Google Chrome、Microsoft Edge 和 Mozilla Firefox 的文件批量下载工具。它能找到普通链接提取工具遗漏的 PDF、Office 文档、图片、ZIP 和 CSV,保存所选文件,还能合并 PDF、打包 ZIP,并将文件 URL 导出为 CSV。免费版每次下载最多保存 10 个文件;$19.99 一次购买的 Pro 授权可解除这一上限。
Grab All Files 能检测各类图片,包括懒加载图片、CSS 背景图片和 blob URL。将结果筛选为图片类型,选中后一次全部下载,或将图片 URL 列表导出为 CSV。
可以。Grab All Files 在您的浏览器内本地合并所选 PDF。不会上传任何内容,文件始终不离开您的设备。
可以。Grab All Files 内置下载管理器,支持并行数调节、暂停/续传、自动重试以及一键重试失败文件,即使断网也能让大批量任务继续。对于数GB的单个文件或长时间无人值守的任务,您还可以导出URL列表,交给专用下载管理器。
可以,二者互为补充。Grab All Files 擅长在复杂或需登录的页面上发现文件(隐藏于 iframe、查看器、JavaScript 和 CMS 路径之后)。将结果导出为 CSV 或URL列表,交给下载管理器进行大批量下载即可:发现交给 Grab All Files,繁重下载交给下载管理器。
可以。它会在页面构建后读取 JavaScript 渲染的单页应用(React、Next.js、Nuxt、Vue),在您已可打开的页面上使用您现有的浏览器会话,跟随受 CSRF 保护的下载表单,并检测 Cloudflare/WAF 机器人墙以引导恢复。它通过文件签名而非仅凭扩展名确认文件类型,且绝不绕过访问控制或安全防护。
免费版每次下载最多保存 10 个文件,并将所选 1 页保存为 HTML。Pro 可解除文件上限,并将多个相关页面的正文合并为一个 HTML。