
 도구 1
파일 일괄 다운로드
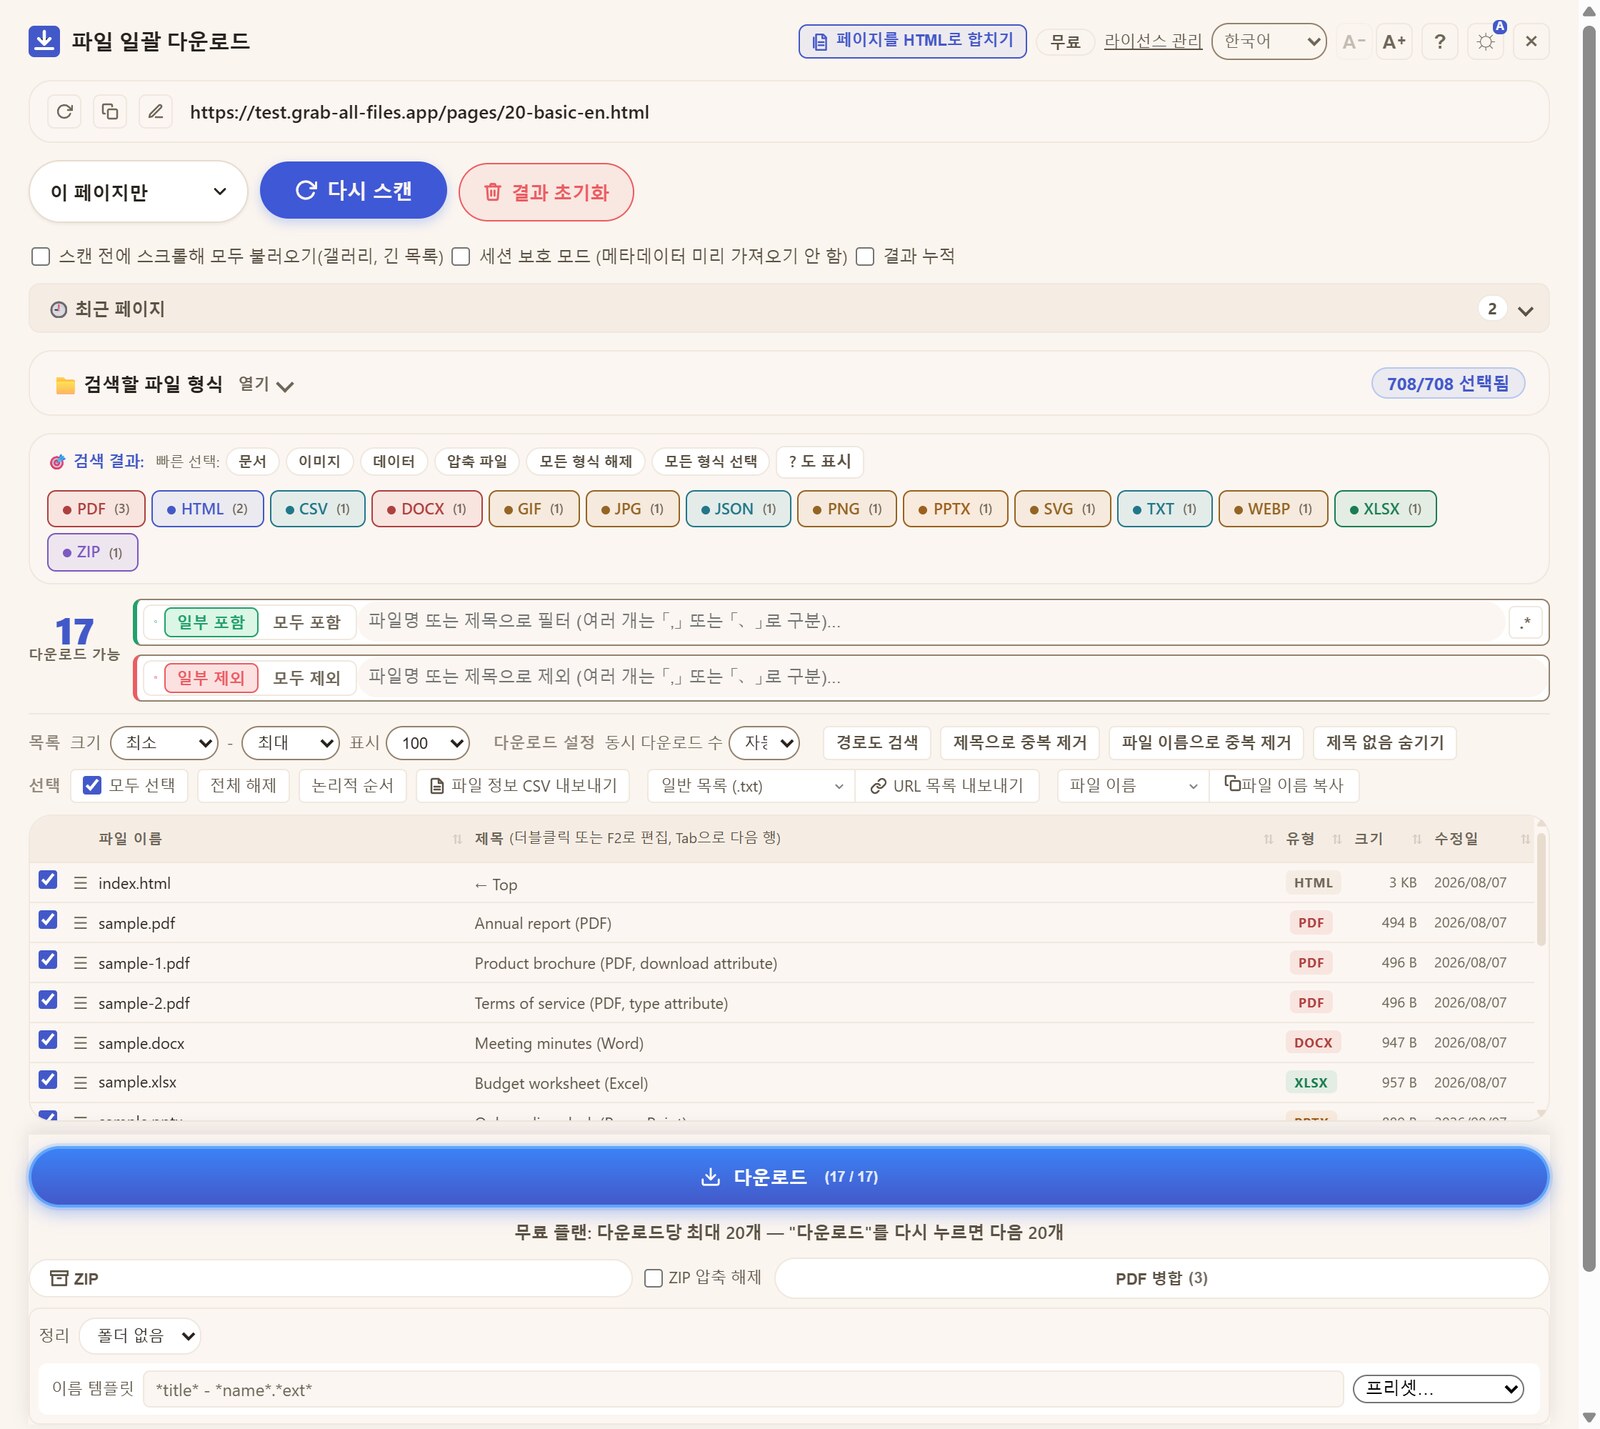
페이지에서 다운로드할 수 있는 모든 파일(708종류)을 찾아, 선택한 파일을 저장합니다.
- iframe, 뷰어, 지연 로딩, fetch/XHR, blob URL 뒤에 있는 파일까지 감지
- PDF 병합, ZIP 생성, CSV 내보내기까지 모두 브라우저 안에서 처리
- 무료 플랜은 다운로드당 최대 10개. 다음 항목을 선택해 “선택한 파일 저장”을 다시 누르면 나머지도 저장할 수 있습니다
Grab All Files는 두 가지 도구를 갖춘 브라우저 확장 프로그램입니다. 파일 일괄 다운로드는 페이지의 PDF·이미지·Office 문서·ZIP 등 다운로드할 수 있는 파일을 찾아, 체크한 파일을 한꺼번에 저장합니다. 페이지를 HTML로 합치기는 웹페이지를 검색 가능한 HTML 하나로 저장합니다(Pro는 관련된 여러 페이지를 하나로). 무료 플랜: 다운로드당 최대 10개 파일, 실행당 1페이지. Pro($19.99 1회 구매): 파일 제한 없음, 여러 페이지 합치기. 모든 처리는 기기에서 이루어집니다.
스마트폰이나 태블릿으로 보고 계신가요? 확장 프로그램은 PC의 Chrome, Edge, Firefox에 설치할 수 있습니다. PC에서 이 페이지를 열어 설치하세요.
브라우저에서 Grab All Files 다운로드: Chrome용 다운로드 Edge용 다운로드 Firefox용 다운로드둘 다 무료 플랜에 포함되며, 확장 프로그램 안의 같은 탭 바에서 전환할 수 있습니다.
도구 1페이지에서 다운로드할 수 있는 모든 파일(708종류)을 찾아, 선택한 파일을 저장합니다.
 도구 2
열려 있는 페이지에서 시작해 관련 페이지를 찾고, 선택한 페이지를 목차가 있는 검색 가능한 HTML 한 파일로 묶습니다.
⋯ 메뉴 항목 이름이 “Pro·라이선스 키”로 바뀌었고, 구매 이메일과 구매 완료 페이지가 키 입력란까지 단계별로 안내합니다. 저장한 HTML의 검색창에 “색상” 버튼(자동·라이트·다크)이 추가되었고, “원래 모양 그대로”는 로컬 폴더뿐 아니라 웹페이지를 수집할 때도 선택할 수 있습니다.
여러 웹페이지에서 문서를 모으는 분들을 위해 만들었습니다: 연구자, 공공 기록물 담당자, 사내 포털 사용자, 디자이너, 학생, 그리고 ‘다른 이름으로 저장…’을 수백 번 클릭하는 데 지친 모든 분.
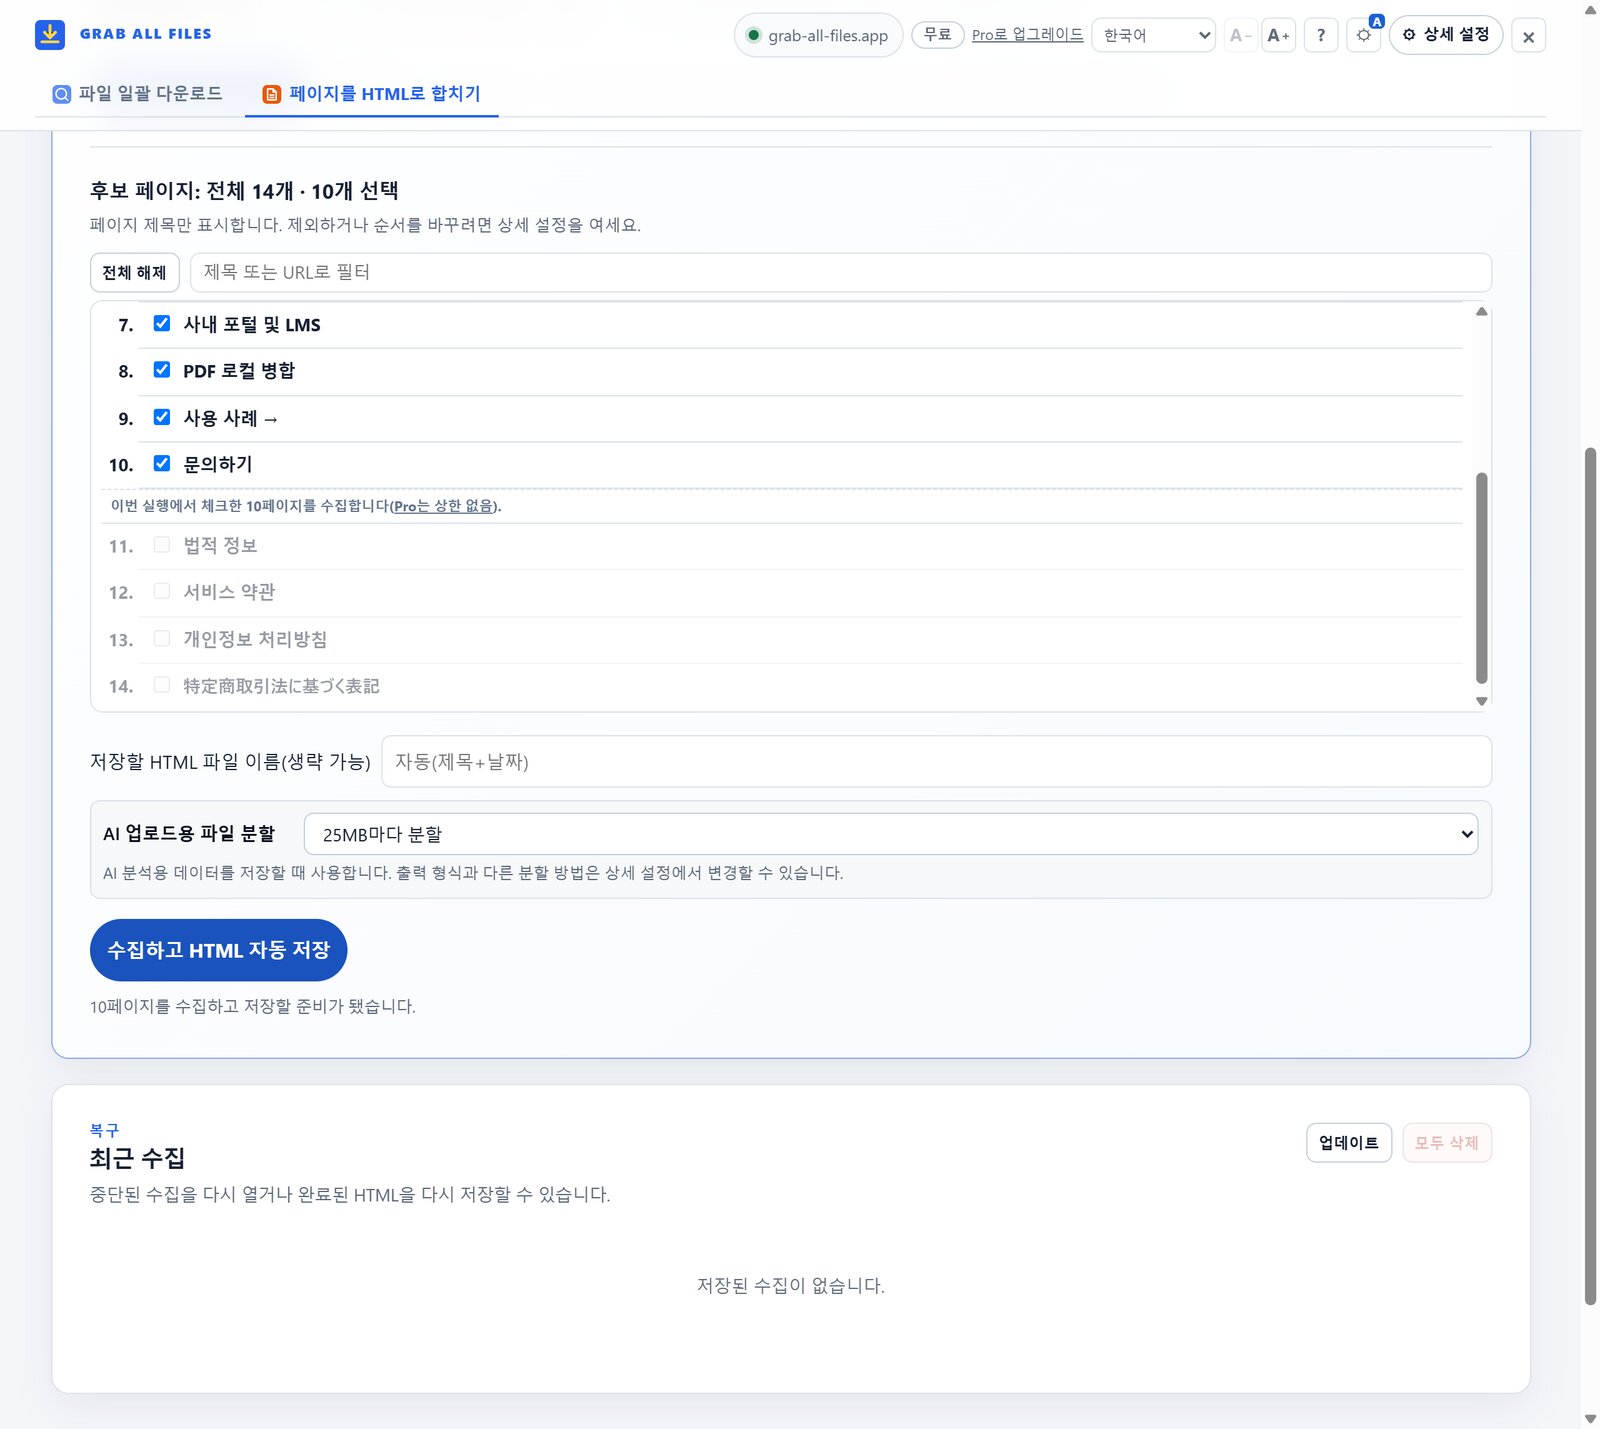
브라우저에 열려 있는 페이지에서 시작하세요. Grab All Files가 관련 페이지를 찾고 포함할 항목을 검토할 수 있게 한 뒤, 선택한 페이지를 목차가 있는 하나의 검색·인쇄 가능한 HTML 파일로 통합합니다.
자동 탐색으로 빠르게 시작하거나 메뉴, 경로, 사이트맵, 붙여넣은 URL 목록을 세부 설정할 수 있습니다. 수집 전에 페이지 제목을 확인하고 필요 없는 페이지를 제거하거나 순서를 바꿀 수 있습니다.
이미지를 포함해 오프라인에서 읽거나 온라인 참조를 유지해 파일 크기를 줄일 수 있습니다. 링크된 PDF, Office 파일 및 기타 문서도 HTML과 함께 저장할 수 있습니다.
출처를 추적할 수 있는 Markdown, JSONL, manifest 및 표 데이터를 분석용으로 생성할 수 있습니다. 페이지 수집 및 HTML 생성은 기기에서 로컬로 실행되며, 페이지 콘텐츠는 당사 서버에 업로드되지 않습니다.
무료 플랜은 관련 후보 페이지를 찾아 목록으로 보여 주고, 사용자가 고른 1개 페이지를 저장합니다. 그 페이지의 이미지에는 플랜 기준 개수 제한이 없고, 그 페이지에서 직접 연결된 파일은 10개씩 저장되며 결과 화면의 ‘다음 10건 저장’으로 나머지를 저장할 수 있습니다. Pro는 여러 후보의 본문을 HTML 하나로 합칩니다. 두 플랜 모두 안전 및 사이트 제한이 적용됩니다.
웹페이지를 하나의 HTML로 합치는 방법 보기 →708종류(확장자)의 파일을 지원합니다. iframe 내 PDF, 지연 로딩 이미지, fetch/XHR 응답, blob URL, CMS 다운로드 경로, 폼의 숨겨진 값, 그리고 단순 링크 수집기가 놓치는 39개의 data-* 속성까지 감지합니다. Shadow DOM / Web Components 내부, SPA 하이드레이션 데이터(Next.js, JSON-LD), Cache Storage / OPFS / IndexedDB, 서명된 클라우드 스토리지 URL(Cloudflare R2, Firebase, Supabase, Vercel Blob)까지 찾아냅니다.
확장자, 파일 크기, 파일 이름, 페이지 제목, 수정일로 결과를 필터링합니다. 정렬, 수동 재정렬, URL 일반 텍스트 복사도 지원합니다.
깊이(0~5 또는 무제한)를 선택해 시작 페이지의 폴더 아래에 있는 같은 사이트 링크를 방문하고(사이트 전체를 대상으로 하려면 사이트 루트에서 시작), 하위 페이지의 PDF, 뷰어 URL, CMS 문서 경로까지 찾아냅니다. 한 번 실행에 최대 100,000페이지. sitemap.xml / robots.txt도 읽고 JavaScript 메뉴(javascript:/onclick), 프레임셋, 이미지 맵, GET 검색/페이지네이션 폼의 링크까지 따라가 일반 HTML 링크가 없는 페이지에도 도달합니다.
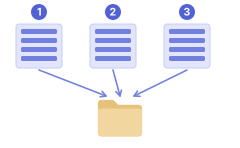
선택한 PDF를 클릭 한 번으로 하나의 파일로 합칩니다. 업로드도 서버도 없이, 파일은 기기에 그대로 남습니다.
선택한 파일을 하나의 ZIP으로 묶어 배포·보관·공유할 수 있습니다. 모두 브라우저 안에서 생성됩니다.
URL, 이름, 크기, 유형, 제목을 CSV로 내보내 문서화, 감사, 자료 목록 관리, 후속 자동화에 활용할 수 있습니다.
현재 브라우저 세션을 사용해 이미 열 권한이 있는 인트라넷, LMS/포털, 회원 전용 페이지를 확인합니다. 인증 정보를 수집하거나 접근 제어를 우회하지 않습니다.
정당하게 접근할 수 있는 페이지 안에서 JavaScript 렌더링 SPA(React, Next, Nuxt, Vue), 뷰어 경로, CSRF 보호 폼을 확인합니다. 파일 형식은 확장자뿐 아니라 시그니처로 확인하며, 오래된 HTTP 페이지도 스캔할 수 있습니다.
여러 URL을 한 번에 스캔하거나 사이트 전체를 크롤링한 뒤, 병렬 다운로드 수 조절, 일시정지/재개, 실패 자동 재시도, 유형·도메인별 폴더 정리, PDF 제목으로 파일명 변경까지.
Grab All Files는 두 가지 작업에 집중합니다. 복잡하거나 로그인이 필요한 페이지에서 파일을 찾고, 선택한 여러 페이지를 읽기 쉬운 HTML 하나로 만듭니다. 다운로드 관리자와 사이트 복제 도구는 다른 역할을 담당합니다.
iframe, 뷰어, JavaScript, 로그인, CMS 경로 뒤에 숨은 PDF·이미지·문서. Grab All Files가 감지하고 필터링·선택 후 일괄 다운로드, PDF 병합, ZIP 생성, CSV 내보내기까지 로컬로 처리합니다.
매우 큰 파일이나 대기열 관리·재개가 필요한 장시간 무인 배치에는 전용 다운로드 관리자(JDownloader, aria2)가 이상적입니다. Grab All Files가 파일을 찾아 URL 목록을 내보내면, 무거운 작업은 그쪽에 맡기세요.
원본 페이지, 링크, 구조를 유지하는 탐색 가능한 복제본이 필요하다면 HTTrack 같은 웹사이트 복사 도구를 사용하세요. Grab All Files는 그 대신 선택한 페이지의 읽기 쉬운 콘텐츠를 목차가 있는 하나의 HTML 파일로 통합하며, 사이트의 화면을 픽셀 단위까지 똑같이 복제하는 도구는 아닙니다.
시·군·구, 시·도, 중앙 부처 사이트에서 PDF 보고서, 신청서, 공개 자료를 한꺼번에 다운로드합니다.
여러 교수 페이지와 저장소에 흩어진 논문, 강의 자료, 실험 보고서, 데이터셋 파일을 모읍니다.
인트라넷, 학습 관리 시스템(Moodle, Canvas, Blackboard), 회원 사이트의 첨부 자료를 모읍니다.
이미지 갤러리, 데이터셋 파일, CSV 내보내기 파일을 오프라인 검토나 후속 처리용으로 한꺼번에 저장합니다.
목적에 맞는 도구를 선택하세요. 계정이나 페이지 내용 업로드가 필요 없습니다.
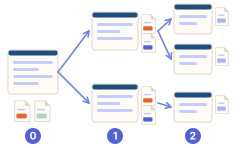
현재 탭을 사용하거나 팝업에 URL을 붙여넣습니다. 크롤링 깊이는 이 페이지만, 같은 사이트 링크 1~5단계, 무제한(한 번 실행에 최대 100,000페이지) 중에서 선택합니다.
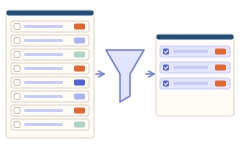
파일 이름, 유형, 크기, 페이지 제목, 출처 URL을 확인할 수 있습니다. 저장 전에 필터링, 정렬, 검색, 순서 변경이 가능합니다.
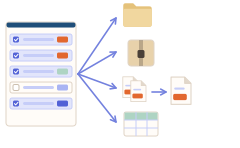
원하는 폴더에 일괄 다운로드하거나(파일 형식별·도메인별 정리 옵션 있음) ZIP으로 묶거나 선택한 PDF를 하나로 병합합니다. 모두 브라우저 안에서 처리됩니다.
“페이지를 HTML로 합치기”로 전환한 뒤 자동 탐색 또는 메뉴·경로·사이트맵·붙여넣은 URL 목록 세부 설정으로 관련 페이지를 찾습니다.
무료 플랜은 후보 1페이지만 선택하고, Pro는 여러 후보를 선택·정렬할 수 있습니다. 이어서 이미지와 직접 연결된 파일 옵션을 선택합니다.
무료 플랜은 선택한 1페이지를 저장하고, Pro는 여러 페이지의 본문을 공통 목차가 있는 검색 가능한 HTML 하나로 합칩니다. 선택적 AI 데이터는 기본 25MB 또는 지정한 크기로 나눌 수 있습니다.
페이지 수집의 모든 선택지에는 그림이 있습니다. 여기 있는 것은 확장 프로그램의 카드 그대로이며, 이름도 화면에 표시되는 것과 같습니다.




무료 플랜은 한 번에 고른 1페이지를 저장합니다. 여러 페이지를 하나의 HTML로 합치는 것은 Pro 기능입니다.
무료
Pro
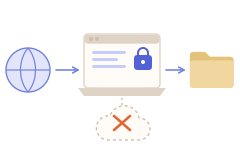 두 플랜 모두 페이지 내용을 기기에서 처리합니다. 안전, 인증, 권한, 사이트 및 기기 보호 제한은 적용됩니다.
파일은 소스 사이트에서 직접 기기로 다운로드됩니다. 라이선스 확인과 선택적 가명 사용 통계만 서버로 전송됩니다. 사용 통계는 기본적으로 꺼져 있으며 명시적으로 동의한 뒤에만 전송됩니다.
Stripe 결제. 구독도 자동 갱신도 없습니다. 영구 라이선스로 키 하나를 최대 3대에서 사용할 수 있습니다. 키는 결제 직후 화면에 표시되고 이메일로도 발송됩니다. 무료 플랜은 기한이 없습니다.
EN / JA / ES / FR / DE / IT / KO / PT-BR / ZH-CN / ZH-TW. 로그인된 세션을 재사용하므로 보호된 포털에서도 작동합니다.
Grab All Files는 PDF, Word, Excel, PowerPoint, 이미지, ZIP, CSV 등 708종류(확장자)의 파일을 지원합니다. 분할 / 멀티볼륨 아카이브 시퀀스(.000/.001…, WinRAR .r00/.s00, WinZip .z01)도 감지하여 압축 아카이브로 분류합니다. 확장자로 필터링하고 필요한 항목을 선택해 한꺼번에 다운로드할 수 있습니다.
네. 무료 플랜은 다운로드당 최대 10개 파일을 일괄 저장하고, 관련 페이지를 찾아 그중 정확히 1개를 선택해 HTML로 저장할 수 있습니다. 선택한 페이지의 이미지에는 플랜 기준 개수 제한이 없고, 직접 연결된 파일은 10개씩 저장되며 결과 화면의 ‘다음 10건 저장’으로 나머지를 저장할 수 있습니다. 안전 및 사이트 제한은 적용됩니다. Pro는 $19.99 1회 구매로 파일 제한을 해제하고 여러 페이지의 본문을 HTML 하나로 합칩니다.
잠기는 기능은 없습니다. 무료 플랜은 다운로드당 최대 10개 파일을 저장합니다. 다운로드가 끝나면 목록에서 다음 파일을 선택한 뒤 “선택한 파일 저장”을 다시 누르세요. 반복하면 나머지도 모두 저장할 수 있습니다. Pro에는 다운로드당 제한이 없습니다.
네, Pro에서 이용할 수 있습니다. 무료 플랜도 관련 페이지를 찾아 목록으로 표시하지만 선택한 1개 페이지만 저장합니다. Pro는 여러 후보를 선택해 읽기 쉬운 본문을 공통 목차와 검색·인쇄가 있는 HTML 하나로 합칩니다.
$19.99 USD 1회 구매. 평생 라이선스, 구독 없음. 최대 3대 기기에서 활성화할 수 있습니다. 기기 1대는 컴퓨터 1대의 브라우저 프로필 1개이며, 확장 프로그램의 라이선스 화면에서 기기를 제거하면 자리를 비울 수 있습니다.
라이선스 키는 결제 직후 구매 완료 페이지에 표시되고 이메일로도 전송됩니다. 확장 프로그램을 열고 오른쪽 위의 “무료”(또는 ⋯ 메뉴 → “Pro·라이선스 키”)를 눌러 키를 붙여넣은 뒤 “활성화”를 누르세요. 오른쪽 위 표시가 “Pro”로 바뀌면 완료입니다.
아니요. 파일은 소스 사이트에서 직접 기기로 다운로드됩니다. 서버로 전송되는 것은 라이선스 확인과 선택적 가명 사용 통계뿐입니다. 사용 통계는 기본적으로 꺼져 있으며 명시적으로 동의한 뒤에만 전송되고, 각 이벤트에는 무작위 설치 ID, 확장 프로그램 버전, 플랜, 대략적인 개수나 라벨(예: 찾은 파일 수)만 담깁니다. 페이지 콘텐츠·URL·파일 이름은 전송되지 않습니다. 자세한 내용은 보안 및 권한을 참고하세요.
Google Chrome 및 Microsoft Edge (Chromium 111 이상), 그리고 Mozilla Firefox (128 이상).
즉시 제공되는 디지털 제품으로 원칙적으로 환불은 불가합니다. 무료 플랜에서 호환성과 1페이지 HTML 저장 및 10개 파일 다운로드를 확인한 후 Pro를 구매할 수 있습니다. 기술적 결함으로 사용할 수 없는 경우 구매일로부터 30일 이내에 문의하면 전액 환불합니다.
네. 확장 프로그램은 기존 브라우저 세션을 사용해 인트라넷, LMS 포털, 회원 전용 영역 등 이미 정당하게 접근할 수 있는 페이지를 스캔합니다. 인증 정보를 수집하거나 접근 제어를 우회하지 않습니다.
Google Chrome, Microsoft Edge 또는 Mozilla Firefox에 Grab All Files를 설치하고 페이지를 열면(또는 URL을 붙여넣으면) iframe, 뷰어, 지연 로딩, fetch/XHR 응답, blob URL, CMS 다운로드 경로 뒤에 숨은 파일까지 감지 가능한 모든 파일이 나열됩니다. 원하는 파일을 선택해 한꺼번에 다운로드하세요.
Grab All Files는 iframe에 삽입된 PDF와 PDF 뷰어 URL까지 포함해 페이지의 모든 PDF를 감지하고, 같은 사이트의 링크를 실행당 최대 100,000페이지까지 크롤링할 수 있습니다. 결과를 PDF로 필터링해 모두 선택한 뒤 일괄 다운로드하거나 브라우저에서 로컬로 PDF 하나로 병합하세요.
Grab All Files는 Google Chrome, Microsoft Edge, Mozilla Firefox용 파일 일괄 다운로드 도구입니다. 일반 링크 추출 도구가 놓치는 PDF, Office 문서, 이미지, ZIP, CSV를 찾아 선택한 파일을 저장하고, PDF 병합, ZIP 아카이브 생성, 파일 URL의 CSV 내보내기를 할 수 있습니다. 무료 플랜은 다운로드당 최대 10개 파일을 저장하며, $19.99 1회 구매 Pro 라이선스로 이 제한을 해제할 수 있습니다.
Grab All Files는 지연 로딩 이미지, CSS 배경 이미지, blob URL을 포함한 이미지를 감지합니다. 결과를 이미지 유형으로 필터링하고 선택해 한 번에 모두 다운로드하거나, 이미지 URL 목록을 CSV로 내보내세요.
네. Grab All Files는 선택한 PDF를 브라우저 안에서 로컬로 병합합니다. 아무것도 업로드되지 않으며 파일은 기기를 벗어나지 않습니다.
네. Grab All Files에는 병렬 수 조정, 일시정지/재개, 자동 재시도, 실패한 파일만 원클릭 재시도가 가능한 내장 다운로드 관리자가 있어, 연결이 끊겨도 대량 배치가 계속됩니다. 매우 큰 단일 파일이나 장시간 무인 작업의 경우 URL 목록을 내보내 전용 다운로드 관리자에 넘길 수도 있습니다.
네, 서로 보완합니다. Grab All Files는 iframe, 뷰어, JavaScript, CMS 경로 뒤에 있는 복잡하거나 로그인이 필요한 페이지에서 파일을 찾아내는 데 강합니다. 결과를 CSV나 URL 목록으로 내보내 다운로드 관리자에 넘기면 대량 일괄 다운로드를 맡길 수 있습니다. 파일 찾기는 Grab All Files, 무거운 다운로드는 전용 관리자가 맡습니다.
네. 페이지가 구성된 후 JavaScript로 렌더링되는 SPA(React, Next.js, Nuxt, Vue)를 읽고, 이미 열 수 있는 페이지에서는 기존 브라우저 세션을 사용하며, CSRF로 보호된 다운로드 폼을 따라가고, Cloudflare/WAF 봇월을 감지해 복구를 안내합니다. 확장자뿐 아니라 시그니처로 파일 형식을 확인하며, 접근 제어나 보안 보호를 우회하지 않습니다.
무료 플랜은 다운로드당 최대 10개 파일과 선택한 1페이지를 HTML로 저장합니다. Pro는 파일 제한을 해제하고 여러 관련 페이지의 본문을 HTML 하나로 합칩니다.