✓Gratuit — choisissez 1 page·Pro 19,99 $ achat unique · 3 appareils

Téléchargez les fichiers en masse. Réunissez les pages dans un seul HTML.

Grab All Files est une extension de navigateur avec deux outils. Le téléchargement groupé de fichiers trouve les fichiers téléchargeables d’une page (PDF, images, documents Office, ZIP) et enregistre ceux que vous cochez. Regrouper les pages en HTML enregistre une page web dans un seul HTML consultable ; avec Pro, plusieurs pages associées dans un seul fichier. Version gratuite : jusqu’à 10 fichiers par téléchargement et une page choisie par opération. Pro (19,99 $ en achat unique) : aucune limite de fichiers et regroupement de plusieurs pages. Tout est traité sur votre appareil.

Sur mobile ou tablette ? L’extension s’installe sur Chrome, Edge ou Firefox pour ordinateur. Ouvrez cette page sur votre ordinateur pour l’installer.

Téléchargez Grab All Files dans votre navigateur : Télécharger pour Chrome Télécharger pour Edge Télécharger pour Firefox

Sécurité et autorisations

708types de fichiers (extensions) 100 000pages / exécution 30+signaux de détection 10langues d'interface 0fichier envoyé
Deux outils

Deux outils dans une seule extension.

Les deux sont inclus dans la version gratuite et se changent depuis la même barre d’onglets, dans l’extension.

Outil 1

Téléchargement groupé de fichiers

Trouvez les fichiers téléchargeables d’une page (708 types) et enregistrez votre sélection en un seul clic.

  • Détecte les fichiers derrière les iframes, visionneuses, chargement différé, fetch/XHR et URL blob
  • Fusionnez des PDF, créez un ZIP ou exportez un CSV, le tout dans votre navigateur
  • La version gratuite enregistre jusqu’à 10 fichiers par téléchargement ; sélectionnez les suivants puis cliquez à nouveau sur « Enregistrer la sélection »
Voir les fonctions de téléchargement
Outil 2

Regrouper les pages en HTML

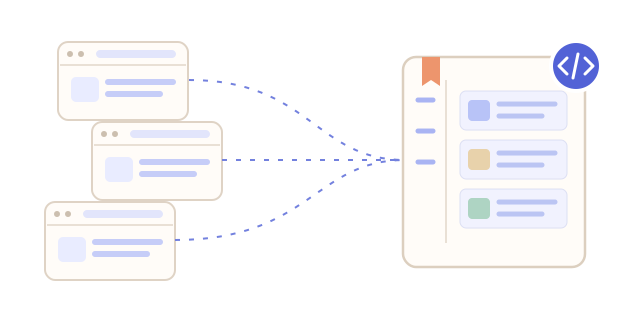
Partez de la page ouverte, trouvez les pages associées et réunissez votre sélection dans un seul fichier HTML avec sommaire et recherche.

  • Découverte automatique ou contrôle détaillé des menus, chemins, sitemaps et listes d’URL collées
  • Vérifiez, réordonnez et retirez des pages avant toute collecte
  • La version gratuite enregistre exactement une page choisie ; Pro sélectionne et regroupe le contenu de plusieurs pages
Voir comment fonctionne la collecte
Dernière version5.8.23

Activation de Pro simplifiée et thème sombre dans le HTML enregistré.

L’entrée du menu ⋯ s’appelle désormais « Pro et clé de licence », et l’e-mail d’achat comme la page de confirmation vous guident pas à pas jusqu’au champ de la clé. Les HTML enregistrés disposent d’un bouton « Thème » (Auto, Clair, Sombre) dans leur barre de recherche, et « Garder l’apparence d’origine » fonctionne aussi pour la collecte de pages web, pas seulement pour les dossiers locaux.

📑Chercheurs 🏛️Archivistes de documents publics 🏢Utilisateurs de portails internes 🎓Étudiants 🎨Designers
Fonctionnalités

Ce que fait l’extension

Conçu pour celles et ceux qui collectent des documents sur de nombreuses pages web : chercheurs, archivistes de documents publics, utilisateurs de portails internes, designers, étudiants et toute personne lassée de cliquer des centaines de fois sur « Enregistrer sous… ».

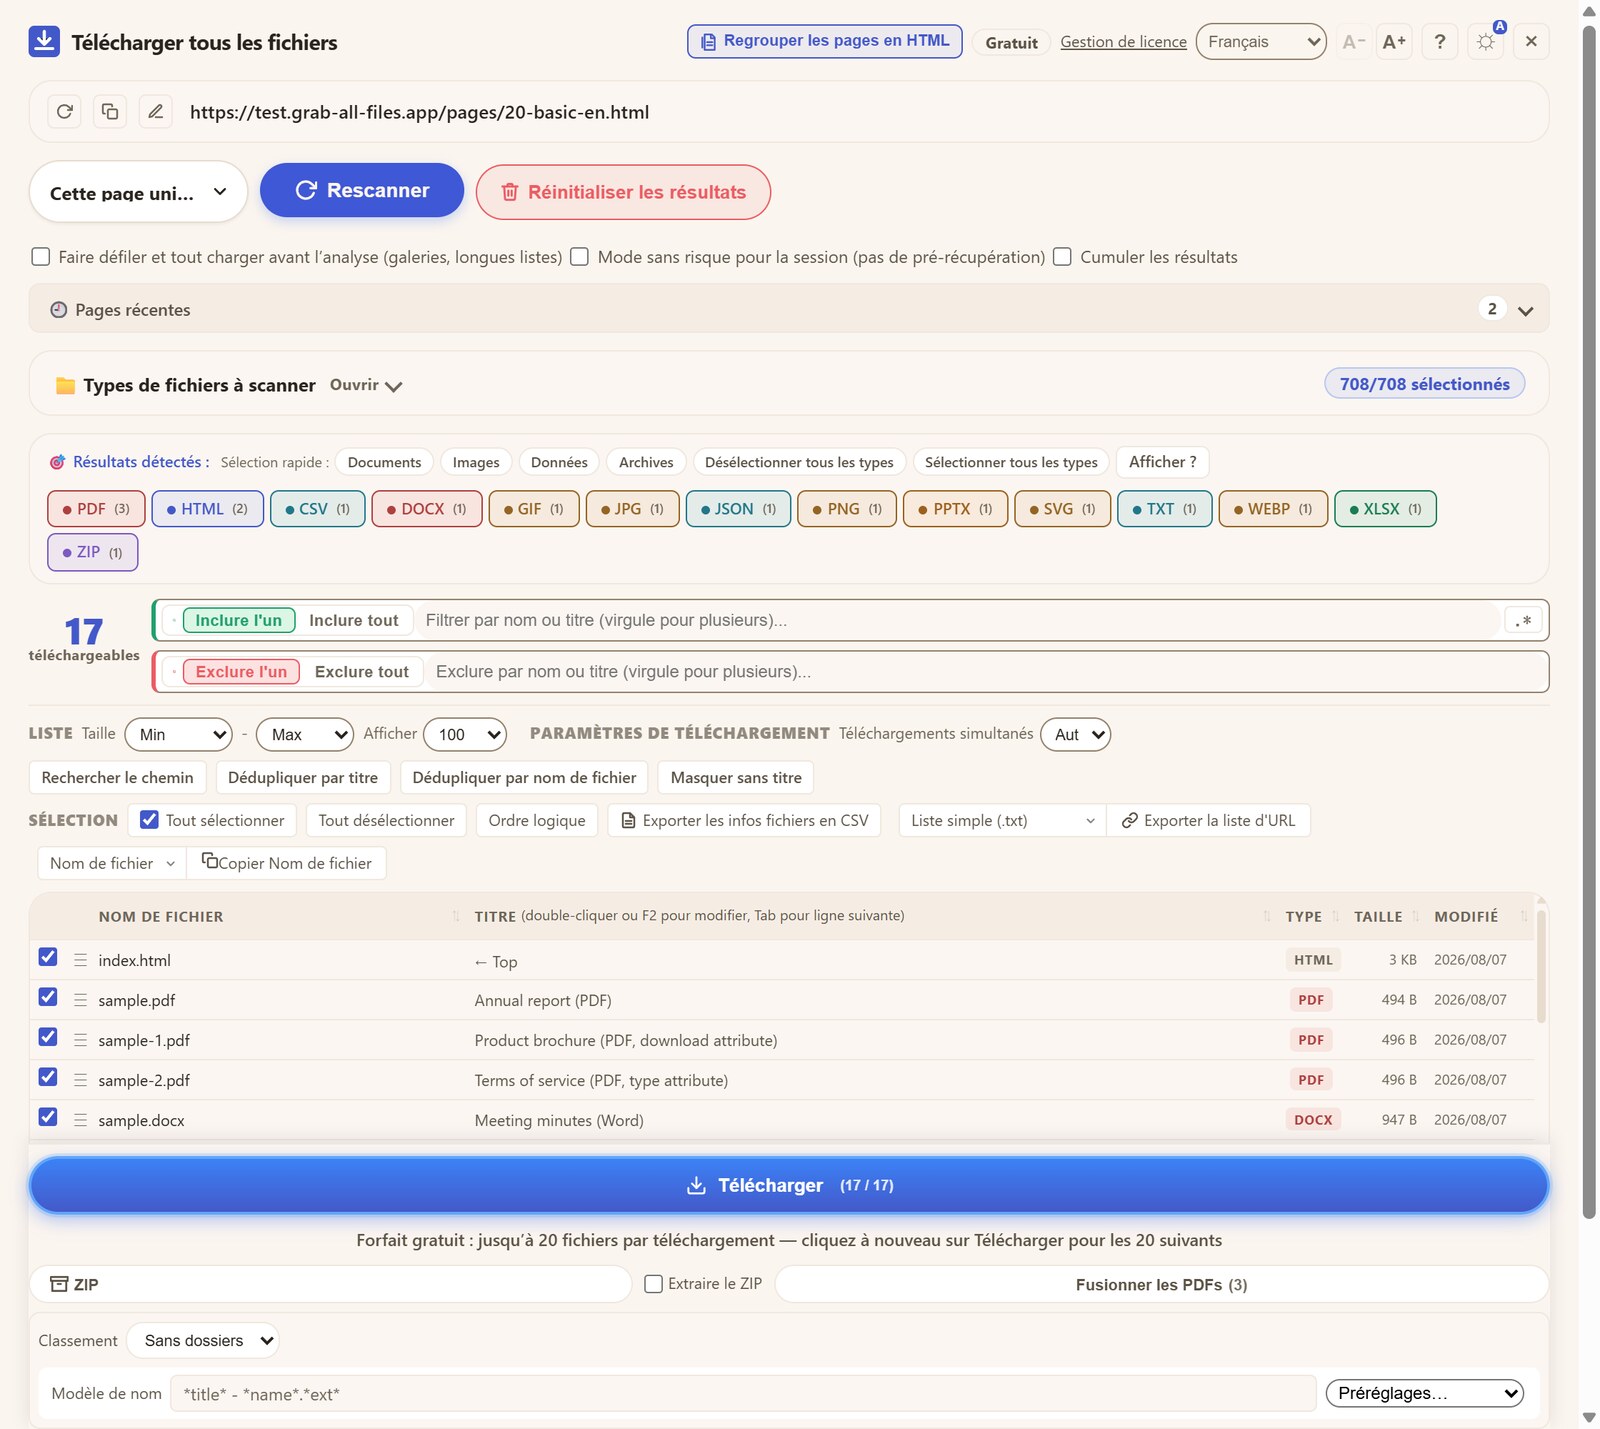
Téléchargeur de fichiers listant 19 fichiers détectés avec type, taille, date et page source ; les 10 premiers sont marqués pour ce téléchargement gratuit
Téléchargeur de fichiersUne analyse réelle de 19 fichiers. La version gratuite enregistre 10 fichiers par téléchargement et indique où s’arrête ce téléchargement ; ZIP, fusion PDF et envoi à l’IA sont à un clic.
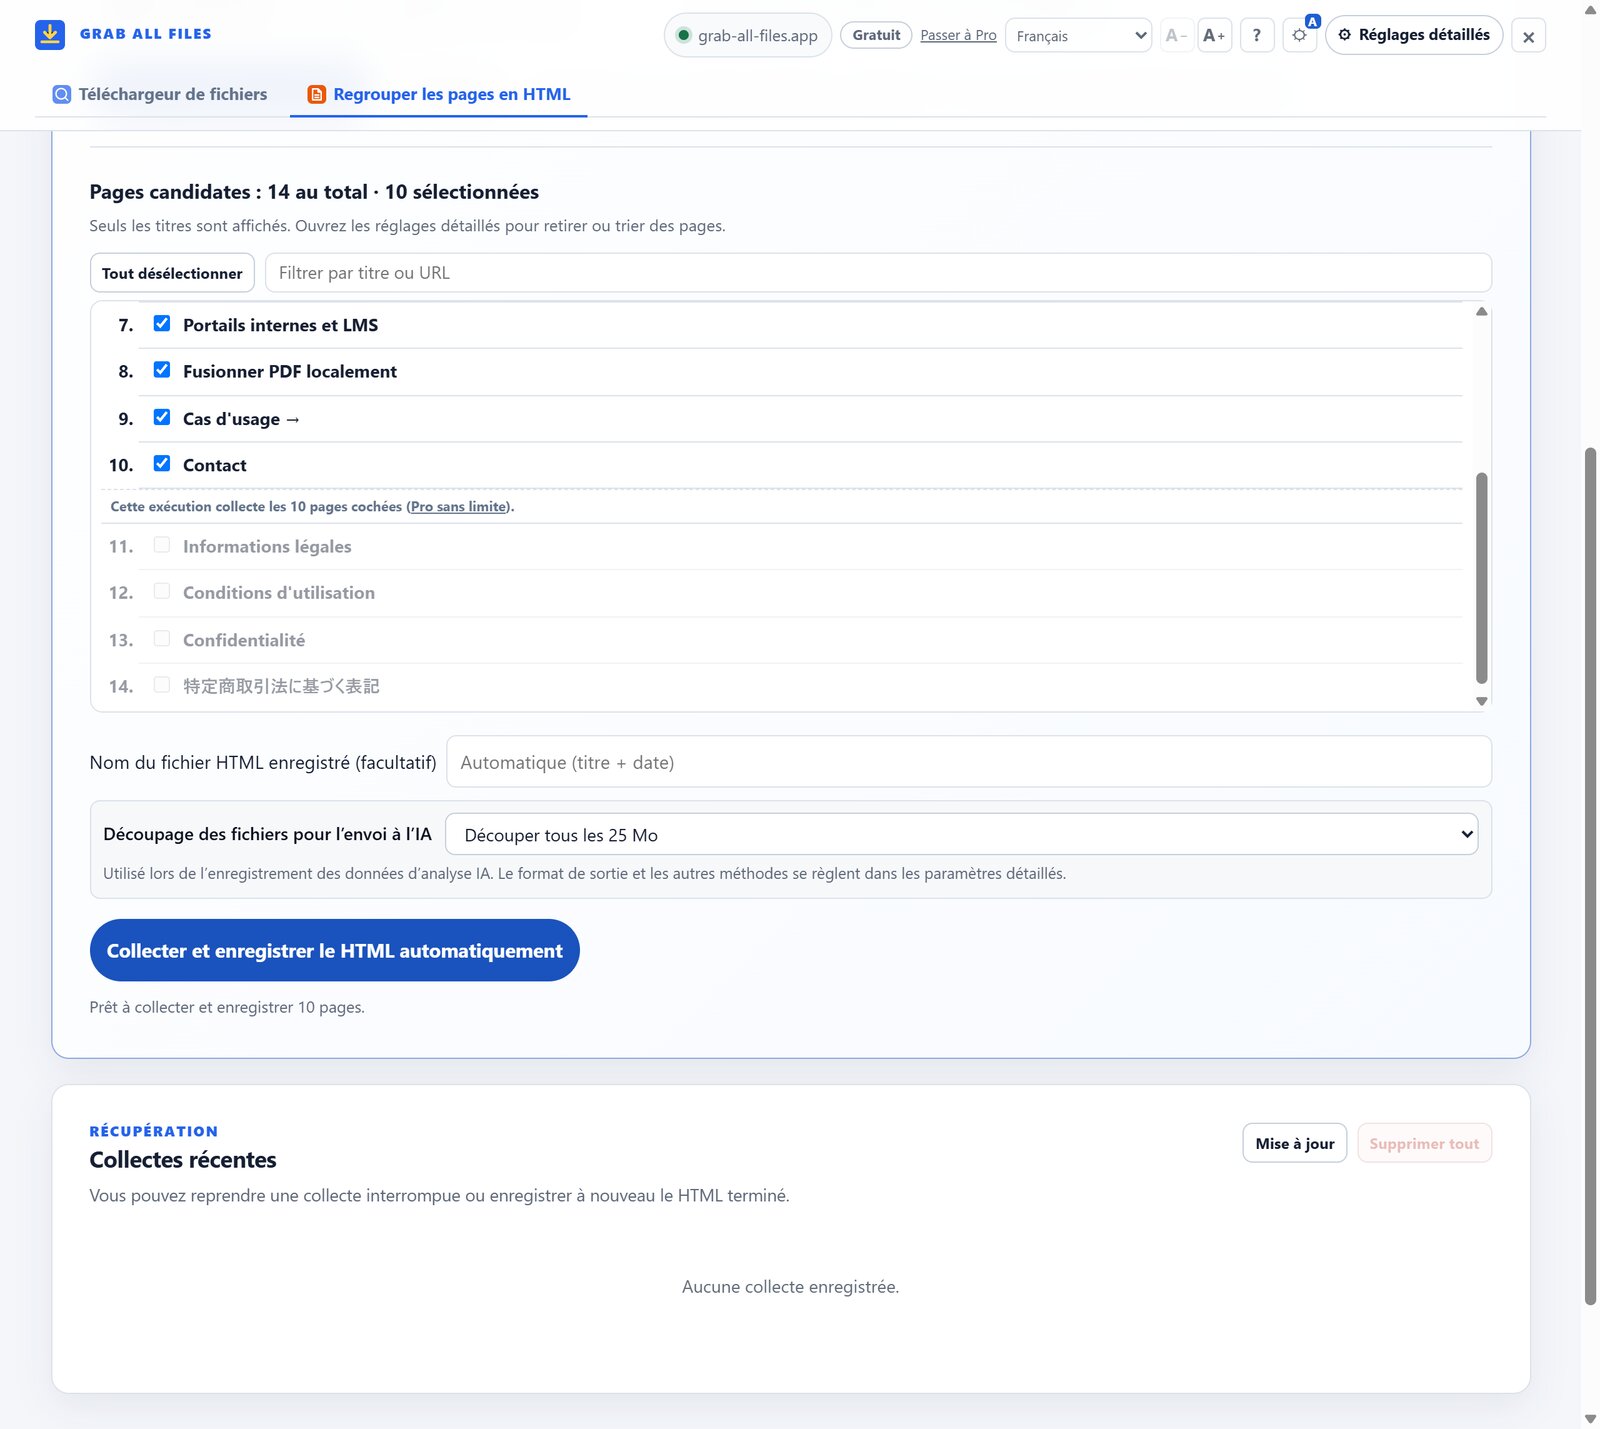
Regrouper les pages en HTML en version gratuite : pages candidates avec une seule page choisie et l’apparence « Garder l’apparence d’origine » sélectionnée
Regrouper les pages en HTMLLa version gratuite enregistre une page choisie par exécution, avec son apparence d’origine si vous le souhaitez ; Pro sélectionne plusieurs candidates et les regroupe dans un HTML.
📑
Regrouper les pages en HTML

Transformez des pages web associées en un seul fichier HTML facile à lire.

Partez de la page ouverte dans votre navigateur. Grab All Files trouve les pages associées, vous permet de vérifier celles qui seront incluses, puis regroupe votre sélection dans un seul fichier HTML avec table des matières, dans lequel vous pouvez effectuer des recherches et que vous pouvez imprimer.

Trouvez et vérifiez les pages

Utilisez la découverte automatique pour démarrer rapidement, ou les réglages détaillés pour les menus, les chemins, les sitemaps et les listes d’URL collées. Vérifiez les titres, puis retirez ou réorganisez les pages avant la collecte.

Enregistrez un document unique et portable

Intégrez les images pour une consultation hors ligne, ou conservez les références en ligne afin d’alléger le fichier. Les PDF, fichiers Office et autres documents liés peuvent être enregistrés avec le fichier HTML.

Export facultatif prêt pour l’IA

Générez du Markdown avec suivi des sources, du JSONL, un manifeste et des données tabulaires à des fins d’analyse. La collecte des pages et la génération du fichier HTML s’effectuent localement sur votre appareil ; le contenu des pages n’est pas envoyé à nos serveurs.

La version gratuite trouve et affiche les pages associées, puis enregistre l’unique page que vous choisissez. Les images de cette page n’ont pas de limite de nombre liée à l’offre ; les fichiers directement liés depuis cette page sont enregistrés par lots de 10, et « Enregistrer les 10 suivants » sur l’écran de résultat enregistre le reste. Pro sélectionne plusieurs candidates et regroupe leur contenu principal dans un HTML. Les limites de sécurité et du site source s’appliquent dans les deux cas.

Voir comment regrouper des pages web en un HTML →
Collecter, lire et analyser avec l’IA →
Enregistrer manuels et connaissances →
🔎

Trouve les fichiers cachés

Prise en charge de 708 types de fichiers (extensions). Détecte les PDF dans les iframes, les images à chargement différé, les réponses fetch/XHR, les URLs blob, les routes de téléchargement CMS, les valeurs cachées de formulaires et 39 attributs data-* que les simples extracteurs de liens ignorent. Va même chercher dans le Shadow DOM / Web Components, les données d’hydratation des SPA (Next.js, JSON-LD), Cache Storage / OPFS / IndexedDB et les URLs signées de stockage cloud (Cloudflare R2, Firebase, Supabase, Vercel Blob).

⚙️

Filtrage intelligent

Filtrez les résultats par extension, taille de fichier, nom de fichier, titre de page ou date de modification. Triez, réorganisez manuellement et copiez les URL en texte brut.

🕸️

Crawl du même site

Choisissez une profondeur (0–5 ou illimitée) et parcourez les liens situés dans le dossier de la page de départ (démarrez à la racine du site pour couvrir tout le site) afin de faire apparaître les PDF des sous-pages, les URL de visionneuses et les routes de documents CMS, jusqu’à 100 000 pages par exécution. Lit aussi sitemap.xml / robots.txt et suit les liens des menus JavaScript (javascript:/onclick), des framesets, des image maps et des formulaires GET de recherche/pagination, atteignant les pages sans liens HTML classiques.

📚

Fusion PDF locale

Combinez les PDF sélectionnés en un seul fichier, en un clic. Aucun envoi, aucun serveur. Vos fichiers restent sur votre appareil.

🗜️

Archive ZIP

Regroupez les fichiers sélectionnés dans un seul ZIP pour les distribuer, les archiver ou les partager, le tout généré dans votre navigateur.

📊

Export CSV

Exportez les URLs, noms, tailles, types et titres en CSV pour la documentation, l’audit, l’inventaire ou l’automatisation.

🔐

Analyse les pages autorisées

Utilise votre session de navigateur pour analyser les intranets, portails/LMS et pages membres que vous êtes déjà autorisé à ouvrir. Ne collecte pas les identifiants et ne contourne pas les contrôles d’accès.

🛡️

Fonctionne sur les pages complexes

Traite les SPA rendues par JavaScript (React, Next, Nuxt, Vue), les routes de visionneuses et les formulaires protégés par CSRF lorsqu’ils font partie de pages auxquelles vous êtes autorisé à accéder. Confirme le type de fichier par signature, pas seulement par extension, et peut aussi analyser les anciens sites HTTP.

⚙️

Conçu pour les gros travaux

Scannez plusieurs URLs à la fois ou explorez un site entier, puis contrôlez les téléchargements parallèles, pause/reprise, relance automatique des échecs, organisation en dossiers par type ou domaine, et renommage des fichiers d’après le titre du PDF.

Quand l'utiliser

Comment Grab All Files complète les autres outils

Grab All Files se concentre sur deux tâches : trouver des fichiers sur les pages complexes ou avec connexion, et réunir les pages choisies dans un HTML lisible. Les gestionnaires de téléchargement et copieurs de sites répondent à d'autres besoins.

🔎

Trouver des fichiers sur des pages complexes ou avec connexion

PDF, images et documents cachés derrière iframes, visionneuses, JavaScript, connexions et routes CMS. Grab All Files les détecte, permet de filtrer et sélectionner, puis télécharge en masse, fusionne les PDF, crée des ZIP et exporte en CSV, le tout localement.

🚚

Télécharger de nombreuses URL connues ou de gros fichiers

Pour de très gros fichiers ou de longues tâches par lots sans surveillance avec gestion de file et reprise, un gestionnaire de téléchargement dédié (JDownloader, aria2) est idéal. Grab All Files trouve les fichiers et exporte la liste d'URL ; confiez le gros du travail au gestionnaire.

🗺️

Besoin d’une copie hors ligne exacte de tout un site web ?

Utilisez un outil de copie de sites tel que HTTrack lorsque vous avez besoin d’une réplique navigable qui préserve les pages, les liens et la structure d’origine. Grab All Files regroupe plutôt le contenu lisible des pages sélectionnées dans un seul fichier HTML avec table des matières ; il ne crée pas une reproduction visuelle à l’identique du site.

Qui l’utilise

🏛️Archives publiques et gouvernementales

Téléchargez en masse rapports PDF, formulaires de demande et documents publiés sur les sites des communes, des régions et des administrations nationales.

🎓Universités et recherche

Collectez articles, supports de cours, rapports de laboratoire et fichiers de jeux de données répartis entre pages d’enseignants et dépôts.

🏢Portails internes et LMS

Récupérez les documents joints des intranets d’entreprise, des plateformes d’apprentissage (Moodle, Canvas, Blackboard) et des espaces membres.

🖼️Bibliothèques d’images et de données

Enregistrez galeries d’images, fichiers de jeux de données et exports CSV pour les consulter hors ligne ou les traiter ensuite.

Deux parcours, trois étapes chacun

Choisissez l’outil adapté. Aucun compte ni envoi du contenu des pages.

Téléchargement groupé de fichiers

Ouvrez la page ou collez une URL

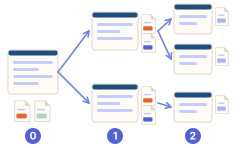
Utilisez l’onglet actuel ou collez une URL dans la fenêtre de l’extension. Choisissez la profondeur d’exploration : cette page seulement, 1 à 5 niveaux de liens du même site, ou illimitée (jusqu’à 100 000 pages par exécution).

L’extension liste tous les fichiers détectables

Les résultats affichent le nom du fichier, le type, la taille, le titre de la page et l’URL source. Filtrez, triez, recherchez et réorganisez avant d’enregistrer.

Sélectionnez et enregistrez, archivez ou fusionnez

Téléchargez en masse vers le dossier de votre choix (classement facultatif par type de fichier ou par domaine), regroupez dans un ZIP ou fusionnez les PDF sélectionnés en un seul, le tout localement dans votre navigateur.

Regrouper les pages en HTML

Ouvrez la page de départ et choisissez la collecte

Passez à « Regrouper les pages en HTML », puis utilisez la découverte automatique ou les réglages détaillés pour les menus, les chemins, les sitemaps et les listes d’URL collées.

Choisissez les pages selon votre offre

La version gratuite garde une seule page candidate sélectionnée à la fois ; Pro permet d’en sélectionner et d’en réorganiser plusieurs. Choisissez ensuite les options d’images et de fichiers directement liés.

Enregistrez le HTML et les données IA facultatives

La version gratuite enregistre la page choisie ; Pro regroupe le contenu principal de plusieurs pages dans un HTML consultable avec table des matières commune. Les données IA facultatives peuvent être découpées en parties de 25 Mo (par défaut) ou à la taille de votre choix.

Regrouper les pages en HTML

Choisissez en image : les mêmes cartes que dans l’extension

Chaque choix du collecteur de pages a son image. Voici les cartes de l’extension elle-même, avec les noms affichés à l’écran.

Pages à collecter

Page actuelle uniquementRegrouper uniquement le contenu principal de la page ouverte
Suivre les liens de cette pageTous les liens de la page, menus comme corps de texte
Dans le menu sélectionnéNaviguez à travers les liens dans la table des matières et le menu latéral
Sous le même cheminParcourez la hiérarchie de l'URL actuelle
Suivre « Suivant »Suit dans l'ordre les liens de page suivante comme Suivant (rel=next).
Coller l'URLRegroupez uniquement les URL spécifiées dans l’ordre dans lequel elles ont été saisies.
Plan du siteCharger des suggestions à partir du sitemap.xml
Pages dans le panierCombine les onglets et liens rassemblés, dans cet ordre

Aspect de la page enregistrée

Facile à lireSeulement le contenu principal, dans un même style. Rapide et léger ; idéal pour lire, imprimer et l’IA.
Garder l’apparence d’origineGarde le design propre du site.

Forme du fichier enregistré : une page

La page telle quelle (standard)Un HTML identique à la page : la recherche du navigateur, l’impression et le PDF fonctionnent comme sur la page elle-même. Sans liste des pièces jointes ni informations de collecte.
Avec sommaire et rechercheLa page est placée dans un cadre sous son titre, son adresse et sa date, avec un sommaire et un champ de recherche. Les pièces jointes trouvées et les informations de collecte peuvent être ajoutées.

Forme du fichier enregistré : deux pages ou plus (Pro)

Avec sommaire et recherche (standard)Chaque page dans un cadre, avec titre, sommaire et champ de recherche. Le fichier le plus léger des trois formes.
Telles quelles, en une longue page (impression et PDF)Les pages telles quelles, l’une après l’autre sur une longue page, sans bloc de titre, sommaire ni recherche. À l’impression, chaque page commence sur une nouvelle feuille.
Chaque page telle quelle (ZIP)Chaque page dans son propre HTML, identique à l’original, avec une page de sommaire (index.html) dans un ZIP.

Données pour les outils d’IA (facultatif)

Un seul MarkdownToutes les pages réunies dans un seul .md avec les sources par page.
Markdown par pageUn .md par page plus manifest.json, regroupés dans un ZIP.
Paquet completcorpus.md, chunks.jsonl, manifest.json, le texte de demande et le HTML lisible dans un ZIP.

Ici, la version gratuite garde une page choisie par exécution ; le regroupement de plusieurs pages dans un HTML relève de Pro.

Un seul achat, sans abonnement.

Comparez la version gratuite et Pro

Gratuit

0 $
Gratuit : 10 fichiers maximum par téléchargement ; sélectionnez les 10 suivants et enregistrez à nouveauGratuit : enregistrez une page choisie en HTML
  • Téléchargement groupé de 10 fichiers maximum par téléchargement ; sélectionnez ensuite les suivants et cliquez à nouveau sur « Enregistrer la sélection »
  • ZIP, fusion PDF, renommage, classement en dossiers et export des liens en CSV/JSON : inclus gratuitement
  • Découvrez et affichez les pages associées
  • Choisissez exactement 1 candidate et enregistrez-la en HTML
  • Images de cette page : aucune limite de nombre liée à l’offre ; fichiers directement liés depuis cette page : par lots de 10, avec « Enregistrer les 10 suivants »
  • Les liens restent cliquables ; le contenu des pages liées n’est pas collecté

Pro

19,99 $ US, achat unique
Pro : tous les fichiers sélectionnés en une foisPro : choisissez plusieurs pages associées et regroupez-les
  • Tout ce que propose la version gratuite, sans limite de fichiers par téléchargement
  • Sélectionnez plusieurs pages associées
  • Regroupez le contenu principal de plusieurs pages dans un HTML consultable avec table des matières commune
  • Licence perpétuelle, sans abonnement, une clé pour 3 appareils maximum
  • Mises à jour incluses ; paiement via Stripe, clé de licence affichée à l’écran et envoyée par e-mail

Le contenu des pages est traité dans votre navigateur et enregistré sur votre ordinateur ; rien n’est envoyé à un serveurLes deux forfaits traitent le contenu sur l’appareil. Les limites de sécurité, d’authentification, d’autorisation, du site et de protection de l’appareil s’appliquent.

🔒Vos fichiers restent sur votre appareil

Les fichiers sont téléchargés directement depuis le site source. Seules la vérification de licence et les statistiques d’utilisation pseudonymes facultatives atteignent nos serveurs. Ces statistiques sont désactivées par défaut et envoyées uniquement après consentement explicite.

💳Un paiement unique, une licence perpétuelle

Paiement via Stripe. Sans abonnement ni renouvellement automatique. Une même clé fonctionne sur 3 appareils au maximum. La clé s’affiche après le paiement et vous est envoyée par e-mail. La version gratuite n’expire jamais.

🌐10 langues, sessions réutilisées

EN / JA / ES / FR / DE / IT / KO / PT-BR / ZH-CN / ZH-TW. Réutilise vos sessions et fonctionne sur les portails protégés.

FAQ

Quels types de fichiers sont pris en charge ?

Grab All Files prend en charge 708 types de fichiers (extensions), dont PDF, Word, Excel, PowerPoint, images, ZIP et CSV. Il détecte aussi les séquences d'archives fractionnées / multivolumes (.000/.001…, WinRAR .r00/.s00, WinZip .z01) et les regroupe comme archives compressées. Filtrez par extension, sélectionnez ce dont vous avez besoin et téléchargez tout en un clic.

Est-ce gratuit ?

Oui. La version gratuite enregistre jusqu’à 10 fichiers par téléchargement et trouve les pages associées afin que vous en choisissiez exactement une à enregistrer en HTML. Les images de cette page n’ont pas de limite de nombre liée à l’offre ; ses fichiers directement liés sont enregistrés 10 par 10, et « Enregistrer les 10 suivants » sur l’écran de résultat enregistre le reste. Pro coûte 19,99 $ en achat unique, supprime la limite de fichiers et regroupe le contenu de plusieurs pages dans un HTML.

Que se passe-t-il quand j’atteins la limite de 10 fichiers ?

Rien n’est bloqué. La version gratuite enregistre jusqu’à 10 fichiers par téléchargement. Une fois celui-ci terminé, sélectionnez les fichiers suivants dans la liste et cliquez à nouveau sur « Enregistrer la sélection » ; répétez jusqu’à tout avoir. Pro supprime la limite par téléchargement.

Puis-je regrouper plusieurs pages web dans un seul fichier HTML ?

Oui, avec Pro. La version gratuite trouve et affiche les pages associées, mais n’enregistre que la page choisie. Pro permet de sélectionner plusieurs candidates et regroupe leur contenu lisible dans un HTML avec sommaire commun, recherche et impression.

Combien coûte Pro ?

19,99 $ US en paiement unique. Licence à vie, sans abonnement. Activable sur 3 appareils au maximum ; un appareil correspond à un profil de navigateur sur un ordinateur, et vous pouvez libérer une place en retirant un appareil depuis l’écran de licence de l’extension.

Comment activer Pro après l’achat ?

Votre clé de licence s’affiche sur la page de confirmation juste après le paiement et vous est aussi envoyée par e-mail. Ouvrez l’extension, cliquez sur « Gratuit » en haut à droite (ou ouvrez le menu ⋯ et choisissez « Pro et clé de licence »), collez la clé et cliquez sur « Activer ». Quand l’étiquette en haut à droite devient « Pro », c’est terminé.

L’extension envoie-t-elle mes données ?

Non. Les fichiers vont directement du site source vers votre appareil. Seules la vérification de licence et des statistiques d’utilisation pseudonymes facultatives (désactivées par défaut, envoyées après consentement explicite) atteignent nos serveurs. Chaque événement contient un identifiant d’installation aléatoire, la version de l’extension, votre offre et des comptages ou libellés approximatifs (par exemple le nombre de fichiers trouvés), jamais le contenu des pages, les URL ni les noms de fichiers. Détails : Sécurité et autorisations.

Quels navigateurs sont pris en charge ?

Google Chrome et Microsoft Edge (Chromium 111 ou ultérieur), et Mozilla Firefox (128 ou ultérieur).

Puis-je obtenir un remboursement ?

En tant que produit numérique livré immédiatement, les remboursements ne sont pas acceptés en principe. La version gratuite permet de vérifier la compatibilité et d’essayer le HTML d’une page et les téléchargements de 10 fichiers avant Pro. Si un défaut technique empêche le fonctionnement, contactez-nous dans les 30 jours suivant l’achat pour un remboursement intégral.

Fonctionne-t-il sur les sites protégés qui exigent une connexion ?

Oui. L’extension utilise votre session de navigateur existante pour analyser les pages auxquelles vous avez déjà un accès autorisé, comme les intranets, les portails LMS et les espaces membres. Elle ne collecte pas les identifiants et ne contourne pas les contrôles d’accès.

Comment télécharger tous les fichiers d’une page web en une fois ?

Installez Grab All Files pour Google Chrome, Microsoft Edge ou Mozilla Firefox, ouvrez la page (ou collez son URL) : l’extension liste tous les fichiers détectables, y compris ceux cachés derrière des iframes, des visionneuses, le chargement différé, des réponses fetch/XHR, des URL blob et des routes de téléchargement CMS. Sélectionnez les fichiers voulus et téléchargez-les tous en un clic.

Comment télécharger tous les PDF d’un site web ?

Grab All Files détecte les PDF d’une page, y compris ceux intégrés dans des iframes et les URL de visionneuses PDF, et peut explorer les liens du même site jusqu’à 100 000 pages par exécution. Filtrez les résultats sur PDF, sélectionnez tout, puis téléchargez-les en masse ou fusionnez-les en un seul PDF localement dans votre navigateur.

Quelle est la meilleure extension Chrome pour télécharger des fichiers en masse ?

Grab All Files est un outil de téléchargement groupé de fichiers pour Google Chrome, Microsoft Edge et Mozilla Firefox. Il trouve les PDF, documents Office, images, ZIP et CSV téléchargeables que les extracteurs de liens ordinaires manquent, puis enregistre les fichiers choisis en un clic, fusionne les PDF, crée des archives ZIP et exporte un CSV des URL de fichiers. La version gratuite enregistre jusqu’à 10 fichiers par téléchargement ; la licence Pro à 19,99 $ en achat unique supprime cette limite.

Comment enregistrer toutes les images d’une page web ?

Grab All Files détecte les images, y compris celles à chargement différé, les images d’arrière-plan CSS et les URL blob. Filtrez les résultats par types d’image, sélectionnez-les et téléchargez-les toutes d’un coup, ou exportez la liste des URL d’images en CSV.

Puis-je fusionner des PDF sans les envoyer sur un serveur ?

Oui. Grab All Files fusionne les PDF sélectionnés localement dans votre navigateur. Rien n’est envoyé : vos fichiers ne quittent jamais votre appareil.

Gère-t-il les téléchargements volumineux ou longs, avec pause et reprise ?

Oui. Grab All Files intègre un gestionnaire de téléchargement avec parallélisme réglable, pause et reprise, nouvelle tentative automatique et relance en un clic des fichiers en échec ; les gros lots se poursuivent même si la connexion tombe. Pour de très gros fichiers uniques ou des tâches longues sans surveillance, vous pouvez aussi exporter la liste d'URL et la confier à un gestionnaire de téléchargement dédié.

Puis-je l'utiliser avec un gestionnaire de téléchargement comme JDownloader ou aria2 ?

Oui, ils se complètent. Grab All Files excelle à trouver des fichiers sur des pages complexes ou nécessitant une connexion (derrière iframes, visionneuses, JavaScript et routes CMS). Exportez les résultats en CSV ou en liste d'URL et confiez-les à votre gestionnaire de téléchargement pour le téléchargement de masse : la découverte dans Grab All Files, le gros du travail dans votre gestionnaire.

Fonctionne-t-il sur les applications JavaScript, les pages avec connexion et les sites protégés contre les bots ?

Oui. Il lit les SPA rendues en JavaScript (React, Next.js, Nuxt, Vue) une fois la page construite, utilise votre session de navigateur existante pour les pages que vous pouvez déjà ouvrir, suit les formulaires de téléchargement protégés par CSRF et détecte les murs anti-bots Cloudflare/WAF pour guider la récupération. Il confirme les types de fichiers par signature, pas seulement par l'extension, et ne contourne jamais les contrôles d'accès ni les protections de sécurité.

Enregistrez des fichiers en masse ou la page web utile.

La version gratuite enregistre jusqu’à 10 fichiers par téléchargement et une page choisie en HTML. Pro supprime la limite de fichiers et regroupe plusieurs pages associées dans un HTML.