
Gardez les articles arXiv utiles.
Cherchez d’abord sur arXiv, puis transformez les résultats affichés en dossier de lecture. Grab All Files détecte les PDF et les liens publics de formats pris en charge sur cette page. Vous vérifiez la liste et choisissez les fichiers.
Fonctionnement du téléchargement de fichiers
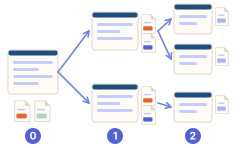
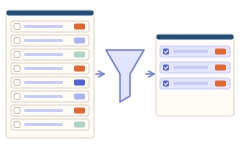
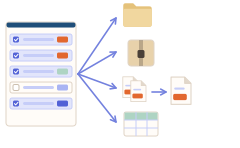
Choisir la liste
- Introduction aux graphes
- Comparaison de méthodes
Vérifier et choisir les PDF
- Introduction aux graphes.pdf
- Comparaison de méthodes.pdf
Enregistrer le dossier
Articles de recherche/
├ Introduction aux graphes.pdf
├ Comparaison de méthodes.pdf
└ files.csv
Exemple illustratif avec titres fictifs. Cherchez sur arXiv, puis sauvegardez les fichiers choisis.
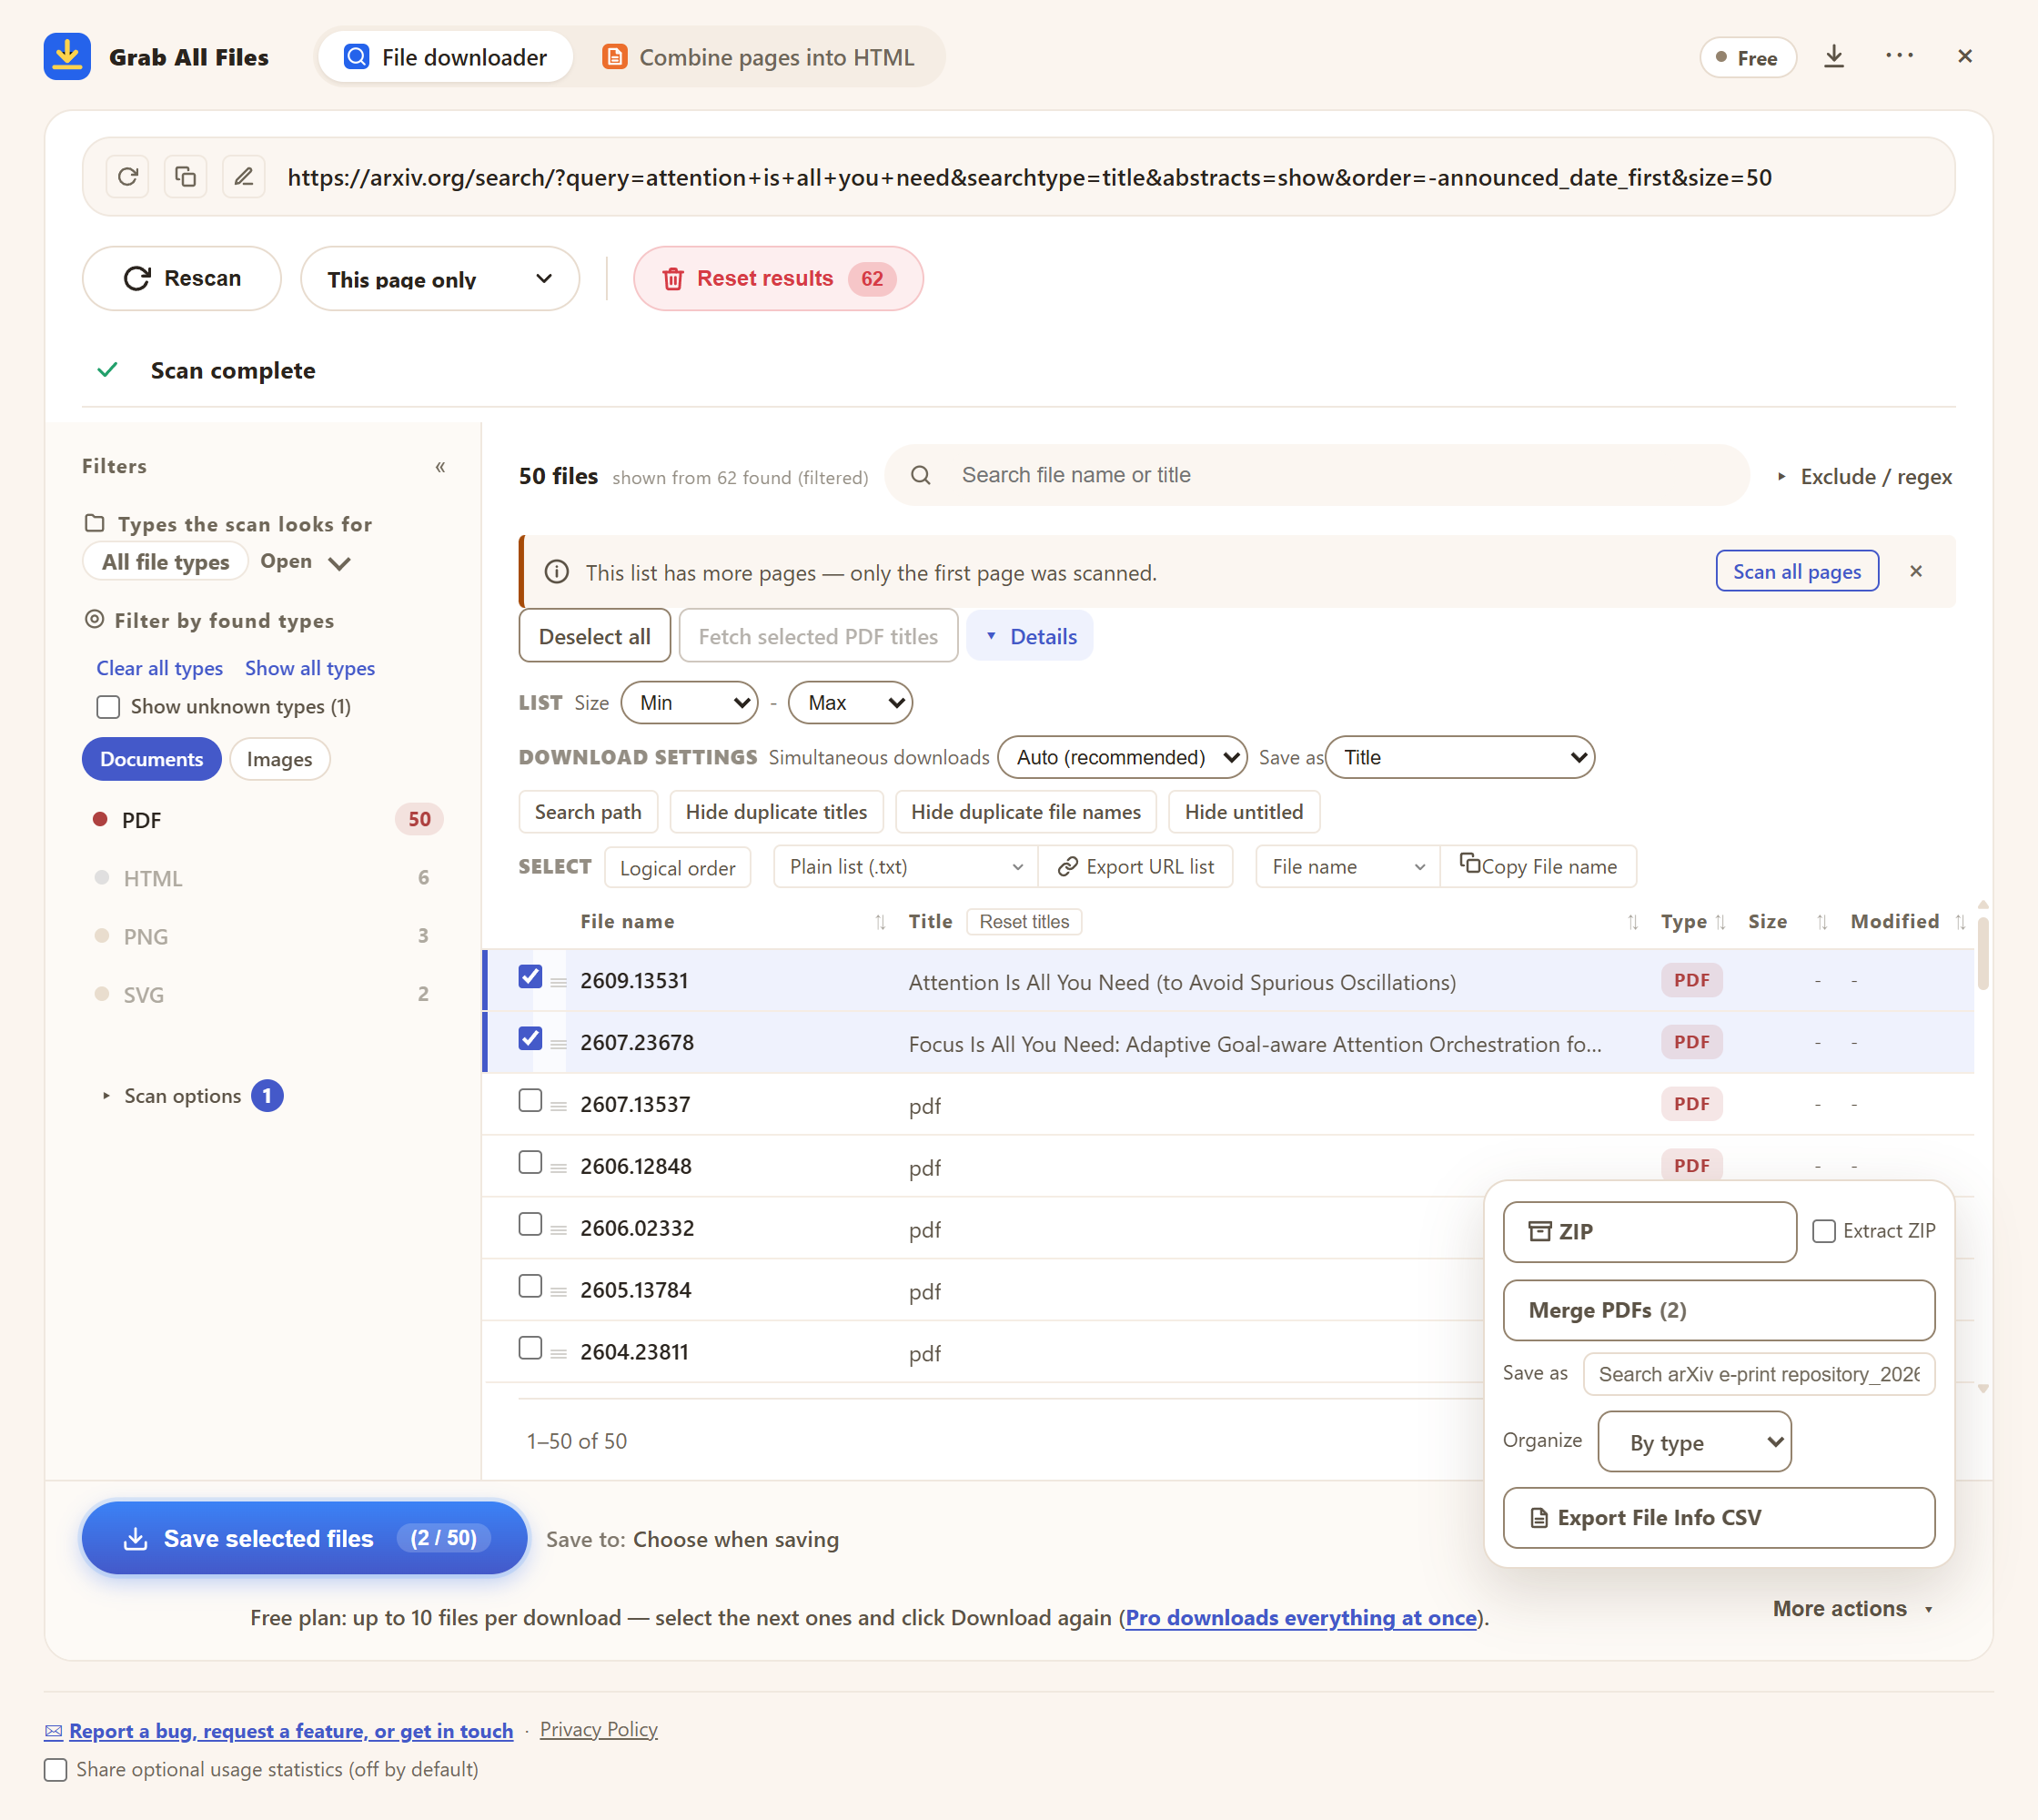
L’extension réelle sur arXiv
Idéal pour
- ✓Créer une liste de lecture depuis une recherche ou catégorie ciblée.
- ✓Enregistrer des PDF choisis avec des noms reconnaissables.
- ✓Conserver les fichiers publics compatibles et un CSV des URL.
Processus
- 1Sur arXiv, affinez les mots-clés, la catégorie et les dates. Ouvrez les résultats ou la liste d’articles.
- 2Ouvrez Grab All Files et analysez la page affichée. Dans la recherche arXiv, affichez d’abord 200 résultats par page pour qu’une seule analyse voie toute la liste. Vérifiez les titres détectés et les URL sources ; « Récupérer les titres des PDF sélectionnés » lit le titre dans le PDF lui-même.
- 3Filtrez sur PDF et sélectionnez les articles utiles : la version gratuite enregistre 10 fichiers par téléchargement, cochez donc les 10 suivants et cliquez à nouveau sur « Enregistrer la sélection » pour continuer. Examinez à part les autres liens publics et ne retenez que les formats pris en charge utiles.
- 4Vérifiez ou modifiez les titres, puis choisissez les noms et le classement des dossiers. Enregistrez les fichiers ou un ZIP et exportez le CSV des URL.
- 5Ouvrez les PDF sauvegardés et vérifiez les résultats. Notez l’URL et la version de l’article. Pour un grand corpus, utilisez les services officiels arXiv.
Choisir la bonne voie d’accès
Pour vos lectures, vérifiez une liste ciblée. Pour un corpus important, utilisez l’accès officiel en masse ; l’API fournit les métadonnées. Consultez les consignes avant toute collecte automatisée.
FAQ
L’extension recherche-t-elle dans tout arXiv ?
Non. Effectuez la recherche sur arXiv. L’extension analyse la page choisie ; ce n’est pas un moteur de recherche scientifique ni un téléchargement exhaustif.
Les liens sans extension .pdf sont-ils détectés ?
Les URL PDF arXiv telles que /pdf/identifiant sont reconnues comme PDF. Vérifiez le type détecté et l’URL avant de sauvegarder.
Et les sources TeX, données et code ?
Seuls les liens publics détectés dans un format pris en charge sont sélectionnables. Ces fichiers n’existent pas pour chaque article ; un dépôt externe peut nécessiter une visite séparée.
Puis-je enregistrer ces articles gratuitement ?
Oui. La version gratuite enregistre jusqu’à 10 fichiers sélectionnés par téléchargement ; pour continuer, sélectionnez les articles suivants et cliquez à nouveau sur « Enregistrer la sélection ». Pro (19,99 $, achat unique, jusqu’à 3 appareils) lève cette limite.
Quel intérêt pour les titres, ZIP et CSV ?
Vérifiez ou modifiez les titres. Le nom automatique reprend le nom original faute de titre utile. Le classement par type ou domaine offre deux options. ZIP regroupe les fichiers ; CSV consigne leurs informations et URL.
Est-ce un outil officiel arXiv ?
Non. Cet outil indépendant n’est pas affilié à arXiv. Respectez les consignes d’accès et les conditions des articles. Utilisez l’API officielle pour les métadonnées et l’accès officiel en masse pour de grands ensembles de PDF ou de textes intégraux.
Guides associés
Essayez Grab All Files dans votre navigateur.
La version gratuite enregistre jusqu’à 10 fichiers par téléchargement dans le téléchargeur de fichiers, et une page choisie par passage pour regrouper des pages en HTML ; les fichiers liés de cette page sont enregistrés par 10 avec « Enregistrer les 10 suivants ». Pro (19,99 $, achat unique, jusqu’à 3 appareils) supprime la limite par téléchargement et regroupe plusieurs pages en un HTML.