
← 用途
✓文件批量下载
一次有序操作,下载网页上的所有文件。
当页面混合PDF、Office文档、图片、ZIP、CSV和fetch响应时,手动保存很慢。Grab All Files 会列出可检测文件和元数据,让您只保留需要的内容。
下载网页文件:扩展程序的实际界面
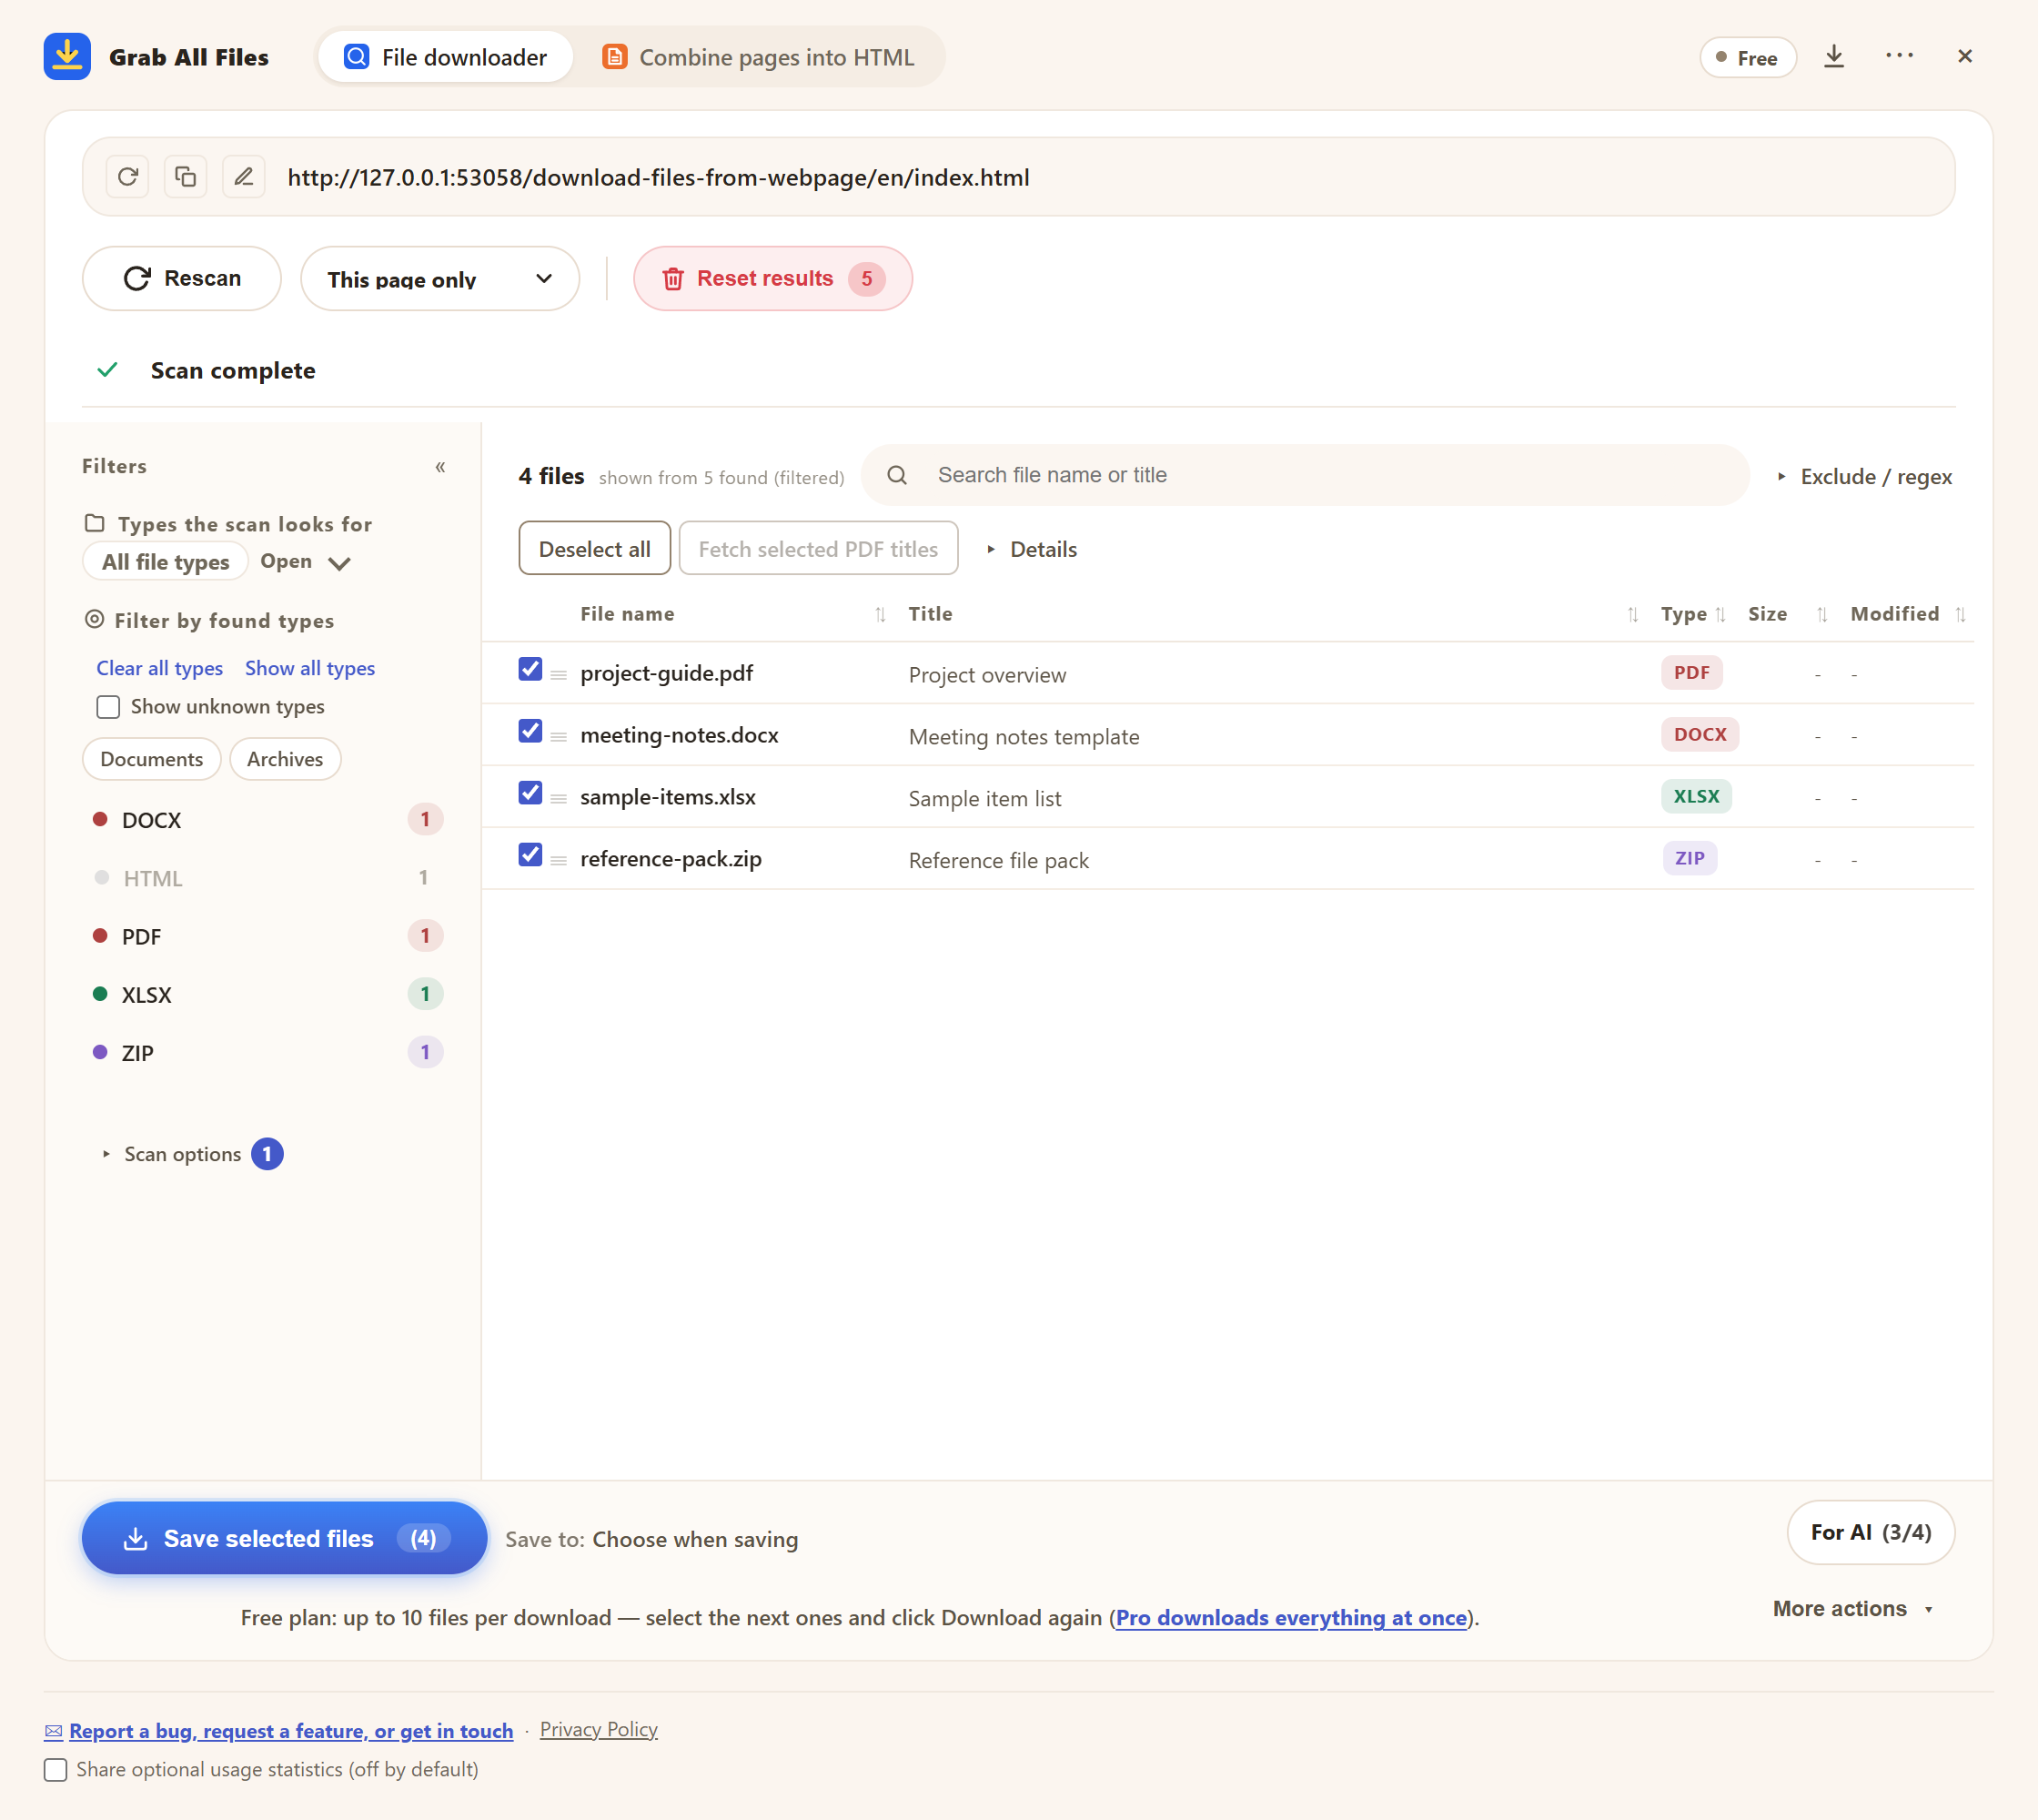
使用示例资料的实际扩展界面。 选择示例页面的受支持文件。 界面为英文。
打开原尺寸图片 ↗文件批量下载的流程
适合用途
- ✓包含大量文档、媒体或压缩包链接的页面。
- ✓文件通过JavaScript、查看器或后台请求出现的页面。
- ✓需要用CSV记录文件URL、大小和来源页面的审计。
- ✓不值得专门搭建爬虫的一次性收集任务。
工作流程
- 1在Chrome、Edge或Firefox中打开页面,点击工具栏上的Grab All Files图标。列表针对当前打开的页面生成。
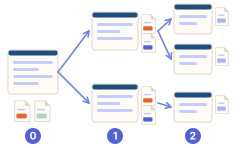
- 2点击“扫描”。如需包含链接到的页面,请先提高“深度”(“仅当前页面”只检查本页);链接只会在起始页面所在的文件夹内跟踪。
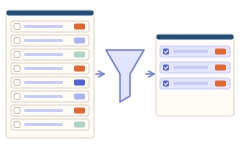
- 3用文件类型列表、文件名/标题搜索框和“详细设置”(最小大小、“保存名称”)缩小列表,勾选需要的文件。
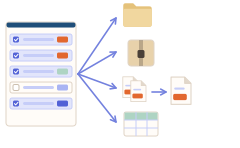
- 4点击“保存所选文件”。ZIP、“合并PDF”、“整理”和“导出文件信息CSV”位于“其他操作”中。免费版每次下载最多保存10个文件。
- 5文件较多时,选择接下来的文件,再次点击“保存所选文件”。失败的行会显示原因,解决访问问题后可重试。
常见问题
支持哪些文件类型?
可检测浏览器能访问的PDF、Office文档、图片、ZIP、CSV和其他可下载响应。还能检测分卷 / 多卷压缩包(如 .001、.r00、.z01)。
能只选择部分文件吗?
可以。按类型、名称、标题或大小筛选,按任意列排序,只勾选需要的行。点击保存按钮之前不会保存任何内容。
免费版有限制吗?
免费版每次下载最多保存10个选中文件,ZIP、“合并PDF”和CSV导出也适用同样的上限。要继续,请选择接下来的文件并再次点击同一按钮即可。Pro($19.99,一次性购买,最多3台设备)没有每次下载的数量限制。
什么都没找到,或比预期少怎么办?
对于滚动时才加载更多内容的页面,请在“扫描设置”中开启“扫描前先滚动并加载全部内容(图库、长列表)”后重新扫描。如果文件在链接到的页面上,请提高“深度”。请在该网站暂停广告拦截器。如果下载由页面自身的JavaScript触发,请在出现时使用“主动抓取”。
页面需要登录怎么办?
请先在同一浏览器中登录网站,再进行扫描。Grab All Files 使用您已有的登录会话;深度为1及以上时,也会用同一登录状态打开链接到的页面。它不会替您登录,也不会绕过访问限制。标有“需要登录”的行,请重新登录后再重试。
旧HTTP页面也可以吗?
可以。浏览器能打开的HTTP和HTTPS页面都可扫描。
相关用途指南
在浏览器中试用 Grab All Files。
免费版在文件批量下载中每次下载最多保存10个文件,将网页合并为HTML时每次保存1个选定页面;该页面直接链接的文件可用“保存接下来的10个”每次保存10个。Pro($19.99,一次性购买,最多3台设备)没有每次下载的上限,并可将多个页面合并为一个HTML。