
← 用途
✓arXiv PDF与研究文件
保存需要的arXiv论文。
先在arXiv搜索,再把正在查看的论文列表整理成阅读资料夹。Grab All Files检测该页面的PDF与受支持格式的公开文件链接。由您核对列表并选择要保存的资料。
文件批量下载的流程
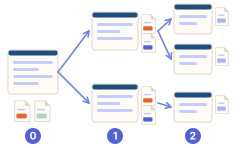
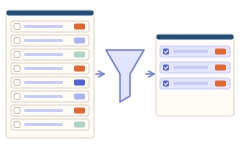
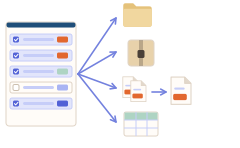
打开论文列表
- 图学习概述
- 方法比较
核对并选择PDF
- 图学习概述.pdf
- 方法比较.pdf
保存研究资料夹
研究论文/
├ 图学习概述.pdf
├ 方法比较.pdf
└ files.csv
使用虚构标题的流程示例。先在arXiv查找,再选择并保存所需文件。
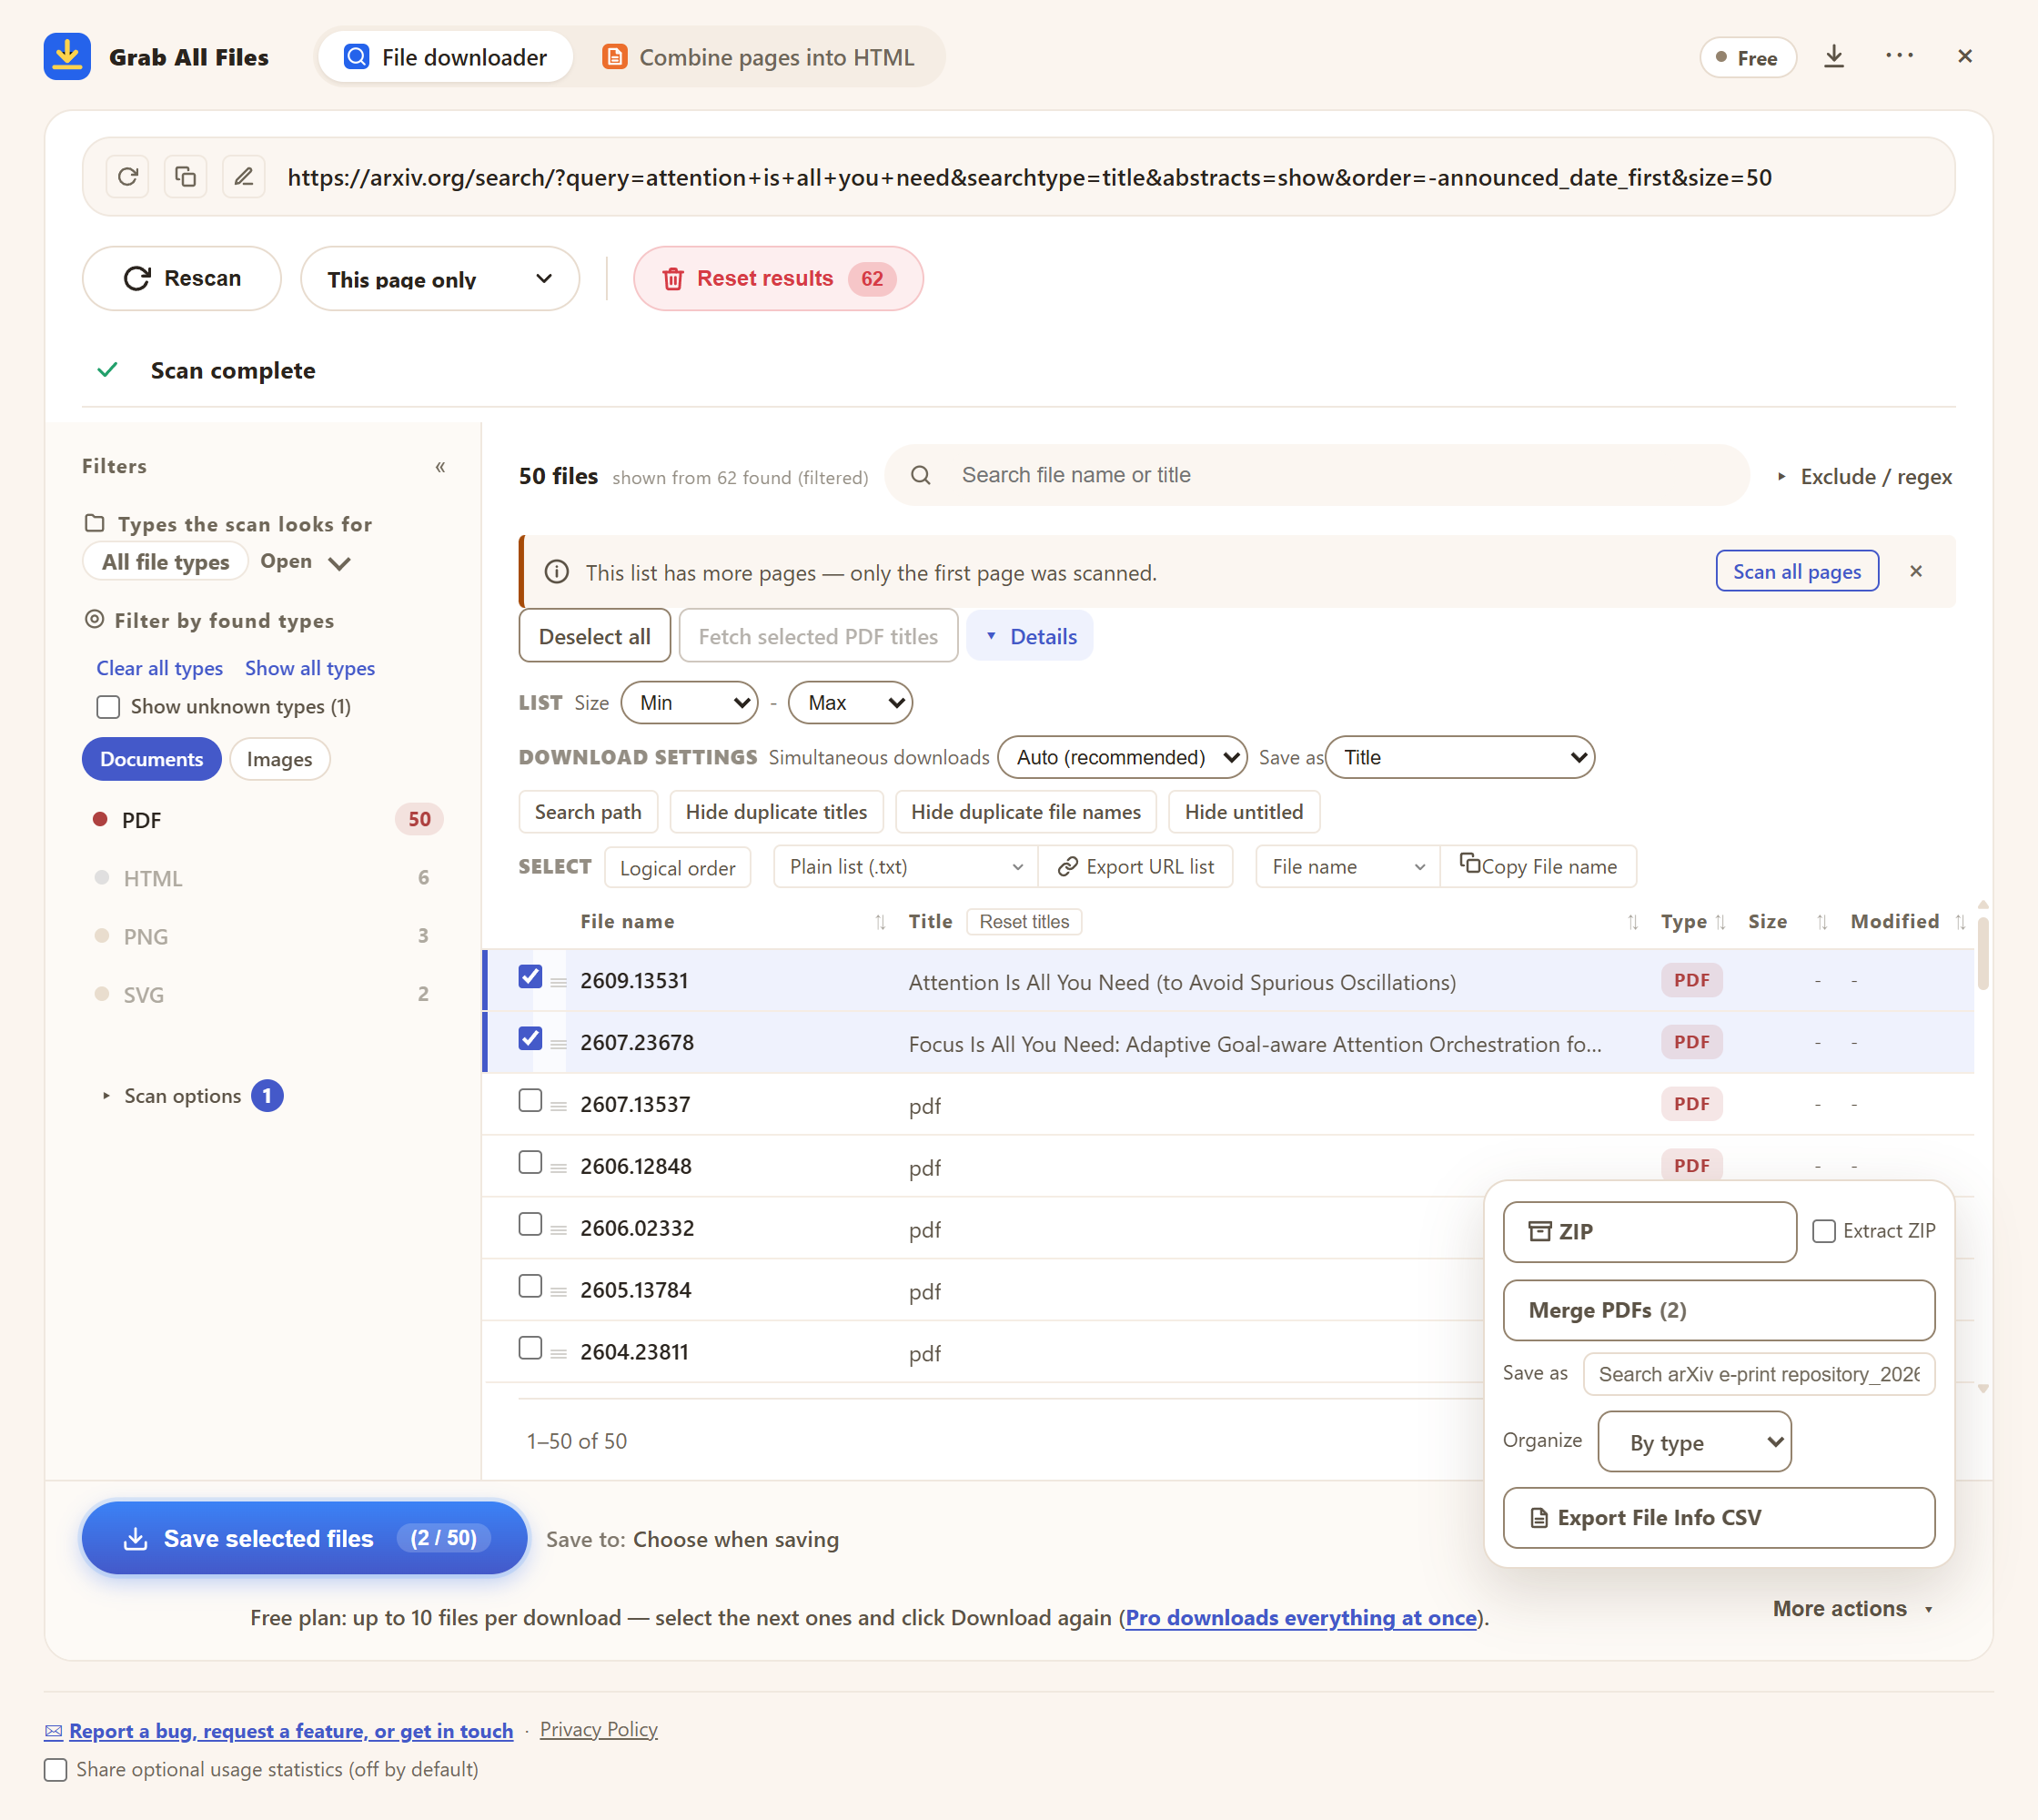
arXiv上的实际扩展界面
适合用途
- ✓从筛选后的搜索或类别列表建立阅读清单。
- ✓以易识别的标题保存选定PDF。
- ✓同时管理受支持的公开文件与记录URL的CSV。
工作流程
- 1在arXiv按关键词、类别和时间筛选,打开目标搜索结果或论文列表。
- 2打开Grab All Files并扫描当前页面。在arXiv搜索结果中先选择每页显示200条,一次扫描即可覆盖整个列表。检查检测到的标题和来源URL;“获取所选PDF的标题”可从PDF本身读取标题。
- 3按PDF筛选并选择需要的论文。免费版每次下载最多10个,继续时勾选接下来的10个并再次点击“保存所选文件”。其他公开文件链接请另行检查,只选择与研究相关的支持格式。
- 4检查或编辑标题,选择保存名称与文件夹方式。单独保存或打包ZIP,并导出文件列表CSV记录URL。
- 5打开已保存PDF核对结果。记录来源URL与论文版本;大规模论文集合使用arXiv官方批量访问服务。
选择合适的arXiv访问途径
阅读资料从筛选后的列表选择。大规模集合使用官方批量访问;API提供元数据。自动收集前请阅读访问指南。
常见问题
扩展会在整个arXiv按主题搜索吗?
不会。搜索与筛选在arXiv完成。扩展扫描选定页面,不是学术搜索引擎或arXiv全站下载器。
没有.pdf后缀的链接能识别吗?
/pdf/论文ID等arXiv PDF URL也可识别为PDF。保存前请核对检测类型与URL。
也能保存TeX、数据和代码吗?
仅能选择发现的公开链接与受支持格式。并非每篇论文都提供这些文件,外部仓库可能需要另行访问。
可以免费保存这些论文吗?
可以。免费版每次下载最多保存10个选中的文件;要继续,请选择接下来的论文并再次点击“保存所选文件”即可。Pro($19.99,一次性购买,最多3台设备)没有每次下载的上限。
标题、ZIP与CSV有什么帮助?
保存前检查或编辑标题。自动命名无有效标题时使用原名。按格式与按来源域名分类是不同选项。ZIP打包选定文件,CSV记录文件信息与URL。
这是arXiv官方工具吗?
不是。Grab All Files为独立工具,与arXiv无合作关系。请遵守访问指南与各论文使用条件。元数据使用官方API,大规模PDF或正文集合使用官方批量访问途径。
相关用途指南
在浏览器中试用 Grab All Files。
免费版在文件批量下载中每次下载最多保存10个文件,将网页合并为HTML时每次保存1个选定页面;该页面直接链接的文件可用“保存接下来的10个”每次保存10个。Pro($19.99,一次性购买,最多3台设备)没有每次下载的上限,并可将多个页面合并为一个HTML。