
保存搜索结果页面上的PDF,并按标题命名。
法规、判决和专利的公开数据库会显示结果页面,每一行背后都有一个PDF。Grab All Files 会扫描该页面,列出找到的每个PDF,并保存您勾选的文件。它保存的是文件。它不判断文本是否现行、是否正确或是否适用,也不提供法律意见。需要数千份文件时,请使用提供方的批量下载或API。
收集什么,以及各类文件通常如何发布
| 典型文件 | 结果页面的样子 | 名称(标题自动生成;其余您自己输入) | |
|---|---|---|---|
| 法律和法规 | 现行文本或官方公报页面的PDF | 标题列表,通常每行一个PDF链接 | 标题;保存日期手动添加 |
| 判决 | 全文的PDF,有时判决书和摘要是两个文件 | 带有“下一个”的结果页面,每行一份判决 | 标题;法院、日期和案号手动添加 |
| 专利和实用新型 | 公开文本或授权专利的PDF | 每页几十行、共几页的命中列表 | 标题;公开号手动添加 |
| 指南和通知 | PDF,有时附带Word或Excel附件 | 按年份分组的链接页面 | 标题;发布日期手动添加 |
只有PDF的标题(或原始名称)可以自动用作文件名。法院、日期、案号和公开号不会替您添加:请手动重命名,或把它们记在文件信息CSV旁边的表格里。在依赖标题之前,请先检查几个。
从结果页面到整洁的文件夹
保存之前先缩小列表,然后选择文件的输出方式。
操作步骤
- 1在浏览器中的数据库里进行搜索,并把显示设置成结果页面尽可能多地显示行数。
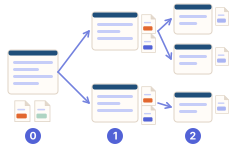
- 2打开结果页面后,启动“文件批量下载”并扫描。如果PDF不在结果页面上,而在每个详情页上,请选择“深度 1”。
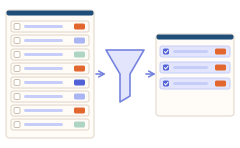
- 3把列表缩小到PDF。免费版只读取屏幕上的内容,因此扫描前请把很长的结果列表滚动到底。Pro 可以替您滚动并跟随列表的“下一个”页面,每次扫描默认最多100页。
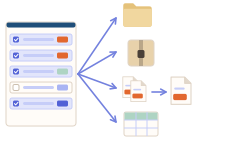
- 4文件名选择“PDF标题”,并选一种适合工作的文件夹分类:按类型、按网站,或不分类。
- 5保存所选文件。使用免费版时,一次保存最多10个文件;选择接下来的文件,再按一次保存。
- 6导出文件信息CSV。其中有每个文件的网址、文件名、标题和来源页面,可以作为您的来源清单保存。
何时改用提供方自己的途径
- ✓数万份文件,或整整一年的判决:请寻找批量下载或API。
- ✓您需要的是结构化数据而不是PDF:提供方的数据文件更合适。
- ✓任何必须保持最新的内容:扩展功能不会监视变化。
- ✓文本是否有效、如何适用:这应由有资质的人员和原始来源判断。
使用条款与文件的性质
公开数据库对自动访问、复制和再利用有各自的规定。在大量收集之前请先阅读,并通过分批保存来控制负载。Grab All Files 不会突破登录或验证码。
您保存的PDF是网站当天提供内容的副本。请在您的列表中,把保存日期写在标题旁边,当需要确切措辞时,请回到来源核对。
相关指南
- 政府公开文件与指南按页面和按年份发布的政府网站。
- PDF重命名与整理为什么标题比编号更适合做名称,以及哪些仍需手动重命名。
- 文件链接导出为CSV文件信息CSV的各列。
常见问题
能把所有搜索结果都下载为PDF吗?
扫描在它读取的页面上找到的大部分PDF都可以保存。受DRM保护或位于浏览器内置PDF查看器中的PDF无法保存。使用免费版时,一次保存10个所选文件,因此很长的结果列表需要分几轮;Pro 每次保存没有上限,还可以滚动并跟随“下一个”页面。数量非常庞大时,请使用提供方的批量下载或API。
PDF会按标题命名吗?
您可以把文件名设为PDF的标题。标题来自PDF本身,所以请检查几个。如果某个PDF没有标题,就使用文件名。
它能告诉我某部法律或某个案例是否现行有效吗?
不能。它保存的是文件。文本是否有效、是否正确、是否与您的事项相关,它不做判断,本页的任何内容也都不是法律意见。
它支持哪些数据库?
它不是为某一个网站设计的。它会找出页面链接或加载的文件,所以通常在您能用浏览器打开的页面上都能工作。有些文件,例如DRM或内置PDF查看器中的文件,无法保存,而且每个网站对自动访问都有自己的规定。
能保留用于引用的来源清单吗?
导出文件信息CSV。其中的“来源页面”列显示每个PDF是在哪里找到的。CSV中没有您保存日期的列,案号或公开号这类您自己的标识也不会自动填写,请在表格里补充。
在浏览器中试用 Grab All Files。
免费版在文件批量下载中每次下载最多保存 10 个文件,将网页合并为 HTML时每次保存 1 个选定页面;该页面直接链接的文件可用“保存接下来的 10 个文件”每次保存 10 个。Pro($19.99,一次性购买,最多 3 台设备)没有每次下载的上限,并可将多个页面合并为一个HTML。