
Grab All Files 能做什么、不能做什么,附具体数字。
Grab All Files 是适用于Chrome、Edge和Firefox的浏览器扩展功能。它能找出网页上的文件,并把页面保存为HTML。本页列出它的限制、免费版和 Pro 的区别,以及它无法保存的页面和文件,并说明这些情况该用哪一类工具。
各项限制
Pro 为US$19.99,一次性付费,无需订阅,一个许可证最多可用于3台设备。免费版无需信用卡。
| 项目 | 数字 | 统计的对象 | 免费版与 Pro |
|---|---|---|---|
| 一次保存的文件数(文件批量下载) | 免费版10个;Pro 无上限 | 您为一次保存所选的文件:下载、ZIP、PDF合并或CSV。使用免费版时,选择接下来的10个并再按一次按钮。 | 这是文件批量下载在两种方案之间的区别。 |
| 一次运行保存的页面数(页面收集) | 免费版1个;Pro 为您所选的全部 | 保存到HTML中的页面。使用免费版时您选择一个候选;可以一次一个地把页面添加到上次保存的HTML中。 | Pro 超过100页时,会先询问是否每100页暂停一次。 |
| 随HTML一起保存的链接文件 | 每次运行,免费版10个;Pro 100个 | 保存的页面所链接的PDF、Word、Excel等文件。结果画面上的按钮可以保存下一批。 | Pro 在链接的文件超过100个时会先询问。 |
| 一次搜索的页面数 | 100,000 | 一次搜索在查找文件或候选页面时最多读取的页面数。sitemap.xml和robots.txt也会读取。 | 两种方案相同。 |
| 搜索深度 | 仅当前页面、深度 1 到 5,或无限制 | 从起始页向外跟随的链接层数。深度在起始页所在的文件夹内起作用。 | 两种方案相同。 |
| 单个ZIP的大小 | 256 MB | 总大小超过200 MB时会出现确认。它不会把ZIP拆分成多个部分。 | 免费版每个ZIP同样限制为10个文件。 |
| 扫描时通过“下一个”跟随的页面数 | 6、20或100页 | 仅限 Pro。扫描会自行滚动到底,并跟随同一列表的“下一个”页面。数量取决于“滚动时间”设置:45秒、90秒或180秒。 | 免费版读取屏幕上的内容,因此请先自己滚动到底。 |
| 设备数 | 3 | 一个 Pro 许可证最多可在3台设备上激活。 | 仅限 Pro。 |
Pro 的“100”是什么,不是什么
Pro 对下载的文件数量没有限制。它的100是“将网页合并为 HTML”中每次运行保存在HTML旁边的链接文件数:即您保存的页面所指向的PDF和Office文件。免费版每次运行保存其中10个。如果链接的文件更多,结果画面上有保存下一批的按钮。
另外有两个数字容易与它混淆。100,000是一次搜索的页面上限,而100也是 Pro 扫描在最长的“滚动时间”设置下跟随的“下一个”页面数。这三者是各自独立的设置。
它能做什么
| 做什么 | 详情 |
|---|---|
| 列出页面上的文件并保存您选择的文件 | 它能检测38个类别中的708种文件类型,包括iframe内的PDF、延迟加载的图片,以及通过fetch/XHR或blob网址加载的文件。保存前您可以对列表进行筛选、排序和搜索。 |
| 保存Office文件、视频文件和音频文件 | Word、Excel和PowerPoint文件,以及页面直接链接的视频和音频文件。免费版和 Pro 相同。 |
| 跟随链接找到更多文件 | 从仅当前页面到无限制深度,每次搜索最多100,000页。 |
| 生成ZIP、合并PDF、导出文件列表 | 全部在您的浏览器中运行。CSV的主要列有网址、文件名、标题、类型、大小和每个文件所在的页面。 |
| 把页面保存为HTML | 四种保存文件的形式和两种外观,“整理为易读格式”或“保持原样”。每个保存的页面都可以带上来源网址和获取时间。 |
| 保存登录后看到的页面和由JavaScript构建的页面 | 它保存浏览器显示的内容,使用您已有的登录状态。它不会保存您的密码,也不会绕过验证码。 |
| 在检查过的网站上读取信息流直到结束 | 在检查过的网站上(X的帖子和回复、YouTube评论、Reddit、Bluesky、Yahoo! News评论),时间线和评论列表会滚动到底,对帖子数量没有上限,并且每1,000条会询问是否继续。在其他页面上,默认最多滚动10次,然后停止。 |
| 在您的电脑上工作 | 页面和文件从来源网站直接到您的电脑。它们不会发送到开发者的服务器。 |
10个文件的限制写在哪里
使用免费版时,保存按钮下方的提示会说明限制以及如何继续。
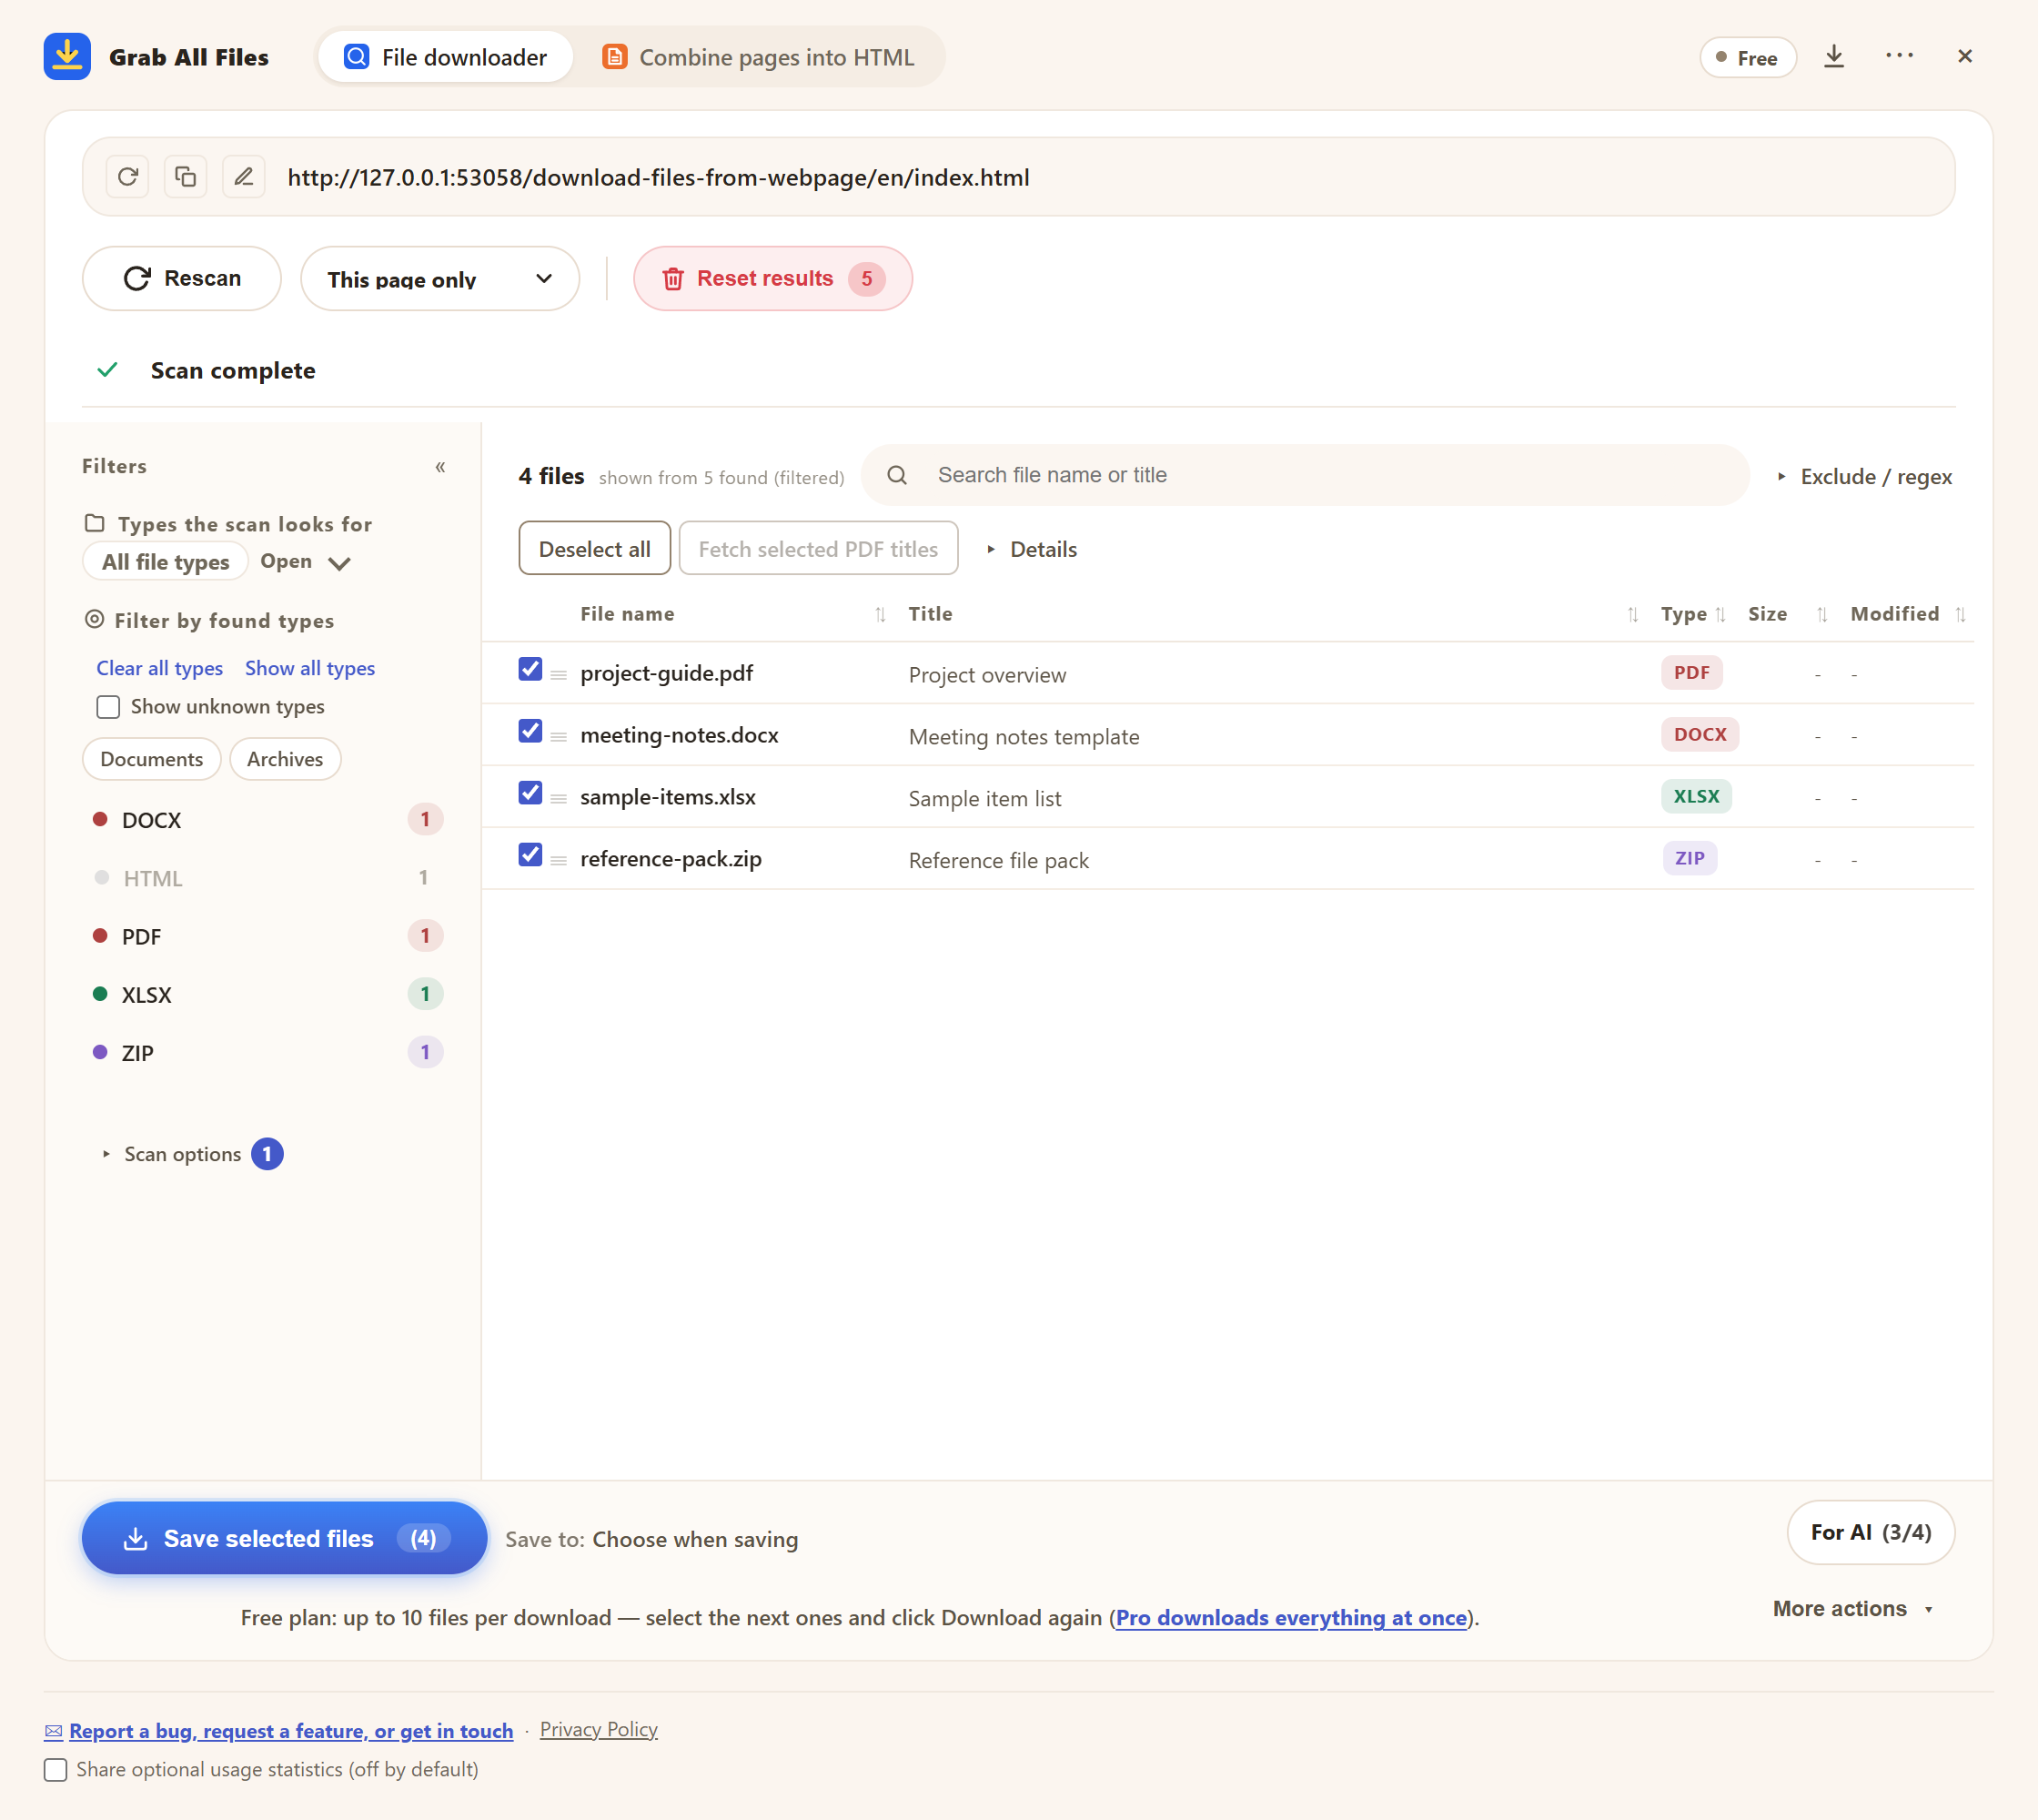
免费版中实际的文件批量下载。保存按钮下方的提示说明免费版每次下载最多保存10个文件,要继续的话,请选择接下来的文件并再按一次下载按钮。
无法保存的内容,以及改用什么
第一列是 Grab All Files 不保存的内容。最后一列给出的是一类工具,而不是某个产品。
| 无法保存 | 会发生什么 | 适合的一类工具 |
|---|---|---|
| 浏览器内部页面(chrome://)、Chrome网上应用店和Edge加载项页面、file://页面 | 它不会在那里运行。 | 对于您电脑上已有的HTML文件,将网页合并为 HTML 中的“从电脑文件夹”选项可以读取它们所在的文件夹或ZIP。其他情况请使用浏览器自带的“将页面另存为”。 |
| 受DRM保护或位于加密查看器中的文件 | 无法读取该文件。 | 如果发布者自己提供下载,请使用该下载。 |
| 浏览器内置PDF查看器的内部、封闭Shadow DOM中的文字、仅在canvas上绘制的文字 | 无法把文字作为文本读取。 | 把屏幕保存为图片,或使用浏览器的打印为PDF。 |
| 来自您未允许的其他域名的iframe | 在您允许之前不会读取。允许之后即可读取。 | 不需要其他工具:浏览器询问时允许该网站即可。 |
| 流媒体视频(HLS .m3u8、DASH .mpd)、blob:播放、没有文件扩展名的播放地址、流媒体网站上的视频 | 它不会保存这些内容,不会绕过DRM或水印,也不会录制流。 | 视频发布者提供的下载功能(如果有的话)。 |
| 您无法登录或无权查看的页面 | 它使用您浏览器的访问权限,不能增加权限。 | 向所有者索取文件,或使用发布者的批量下载或API。 |
| 数千页,或只获取自上次以来有变化的文件 | 它在浏览器内逐页工作,因此这种规模下速度很慢,也没有仅更新模式。 | 桌面版网站复制工具。 |
| 大量论文或公开数据集 | 小批量可以,但不适合处理整个语料库。 | 来源提供的批量下载或API(如果有的话)。 |
相关指南
- 网站复制、单页保存、下载管理器的区别把同样的限制作为各种方式的对比来看。
- Chrome、Edge、Firefox 的区别Firefox 上有什么不同。
- 常见问题关于价格、隐私和权限的简短回答。
常见问题
免费版一次可以下载多少个文件?
每次保存10个文件。用所选内容生成的ZIP、PDF合并和CSV也适用同样的限制。选择接下来的10个并再按一次按钮即可继续。Pro 对文件数量没有上限。
Pro 限制100次下载吗?
不。文件批量下载在 Pro 中没有文件数量上限。100是“将网页合并为 HTML”一次运行中保存在HTML旁边的链接文件数。结果画面上的按钮可以保存下一批。
它最多能搜索多少页?
一次搜索最多100,000页,深度可设为“仅当前页面”、1到5,或无限制。它也会读取sitemap.xml和robots.txt。
ZIP最大能有多大?
256 MB。总大小超过200 MB时会出现确认。它不会把ZIP拆分成多个文件,所以达到上限时请减少所选文件。
能保存流媒体视频吗?
不能。它保存页面直接链接的视频文件,例如.mp4或.webm。它不会保存HLS或DASH流、blob:播放,或流媒体网站上的视频。
有数千页的网站该用什么?
桌面版网站复制工具。Grab All Files 在您的浏览器中一次读取一页。正因为如此,它才能保存需要登录的页面和由JavaScript构建的页面,同时也使得网站达到数千页时速度很慢。
在浏览器中试用 Grab All Files。
免费版在文件批量下载中每次下载最多保存 10 个文件,将网页合并为 HTML时每次保存 1 个选定页面;该页面直接链接的文件可用“保存接下来的 10 个文件”每次保存 10 个。Pro($19.99,一次性购买,最多 3 台设备)没有每次下载的上限,并可将多个页面合并为一个HTML。