
장별 HTML 안내서
필요한 장을 골라 순서대로 HTML 자료집을 만듭니다. 목차와 본문 검색으로 필요한 부분을 다시 찾습니다.
필요한 장과 기사를 모아 읽고 목차와 검색으로 절차를 찾으세요. 설명 페이지와 PDF 원본을 함께 관리합니다. 열람·저장이 허용된 자료를 사용하세요. Free는 선택한 1페이지를 저장하고 Pro는 여러 페이지 본문을 결합합니다.
무료: 1회에 한 페이지. 여러 장을 파일 하나로 합치는 것은 Pro 기능입니다. PDF 문서는 파일 다운로드로 따로 저장합니다.
이 사이트에 올려 둔 가상의 페이지를 Grab All Files 5.8.20으로 실제로 저장한 파일입니다. 사용한 설정과 각 파일의 해시값도 함께 실었습니다. 무료 샘플은 공개 버전으로, Pro 샘플은 같은 소스로 만든 개발용 빌드로 만들었습니다.
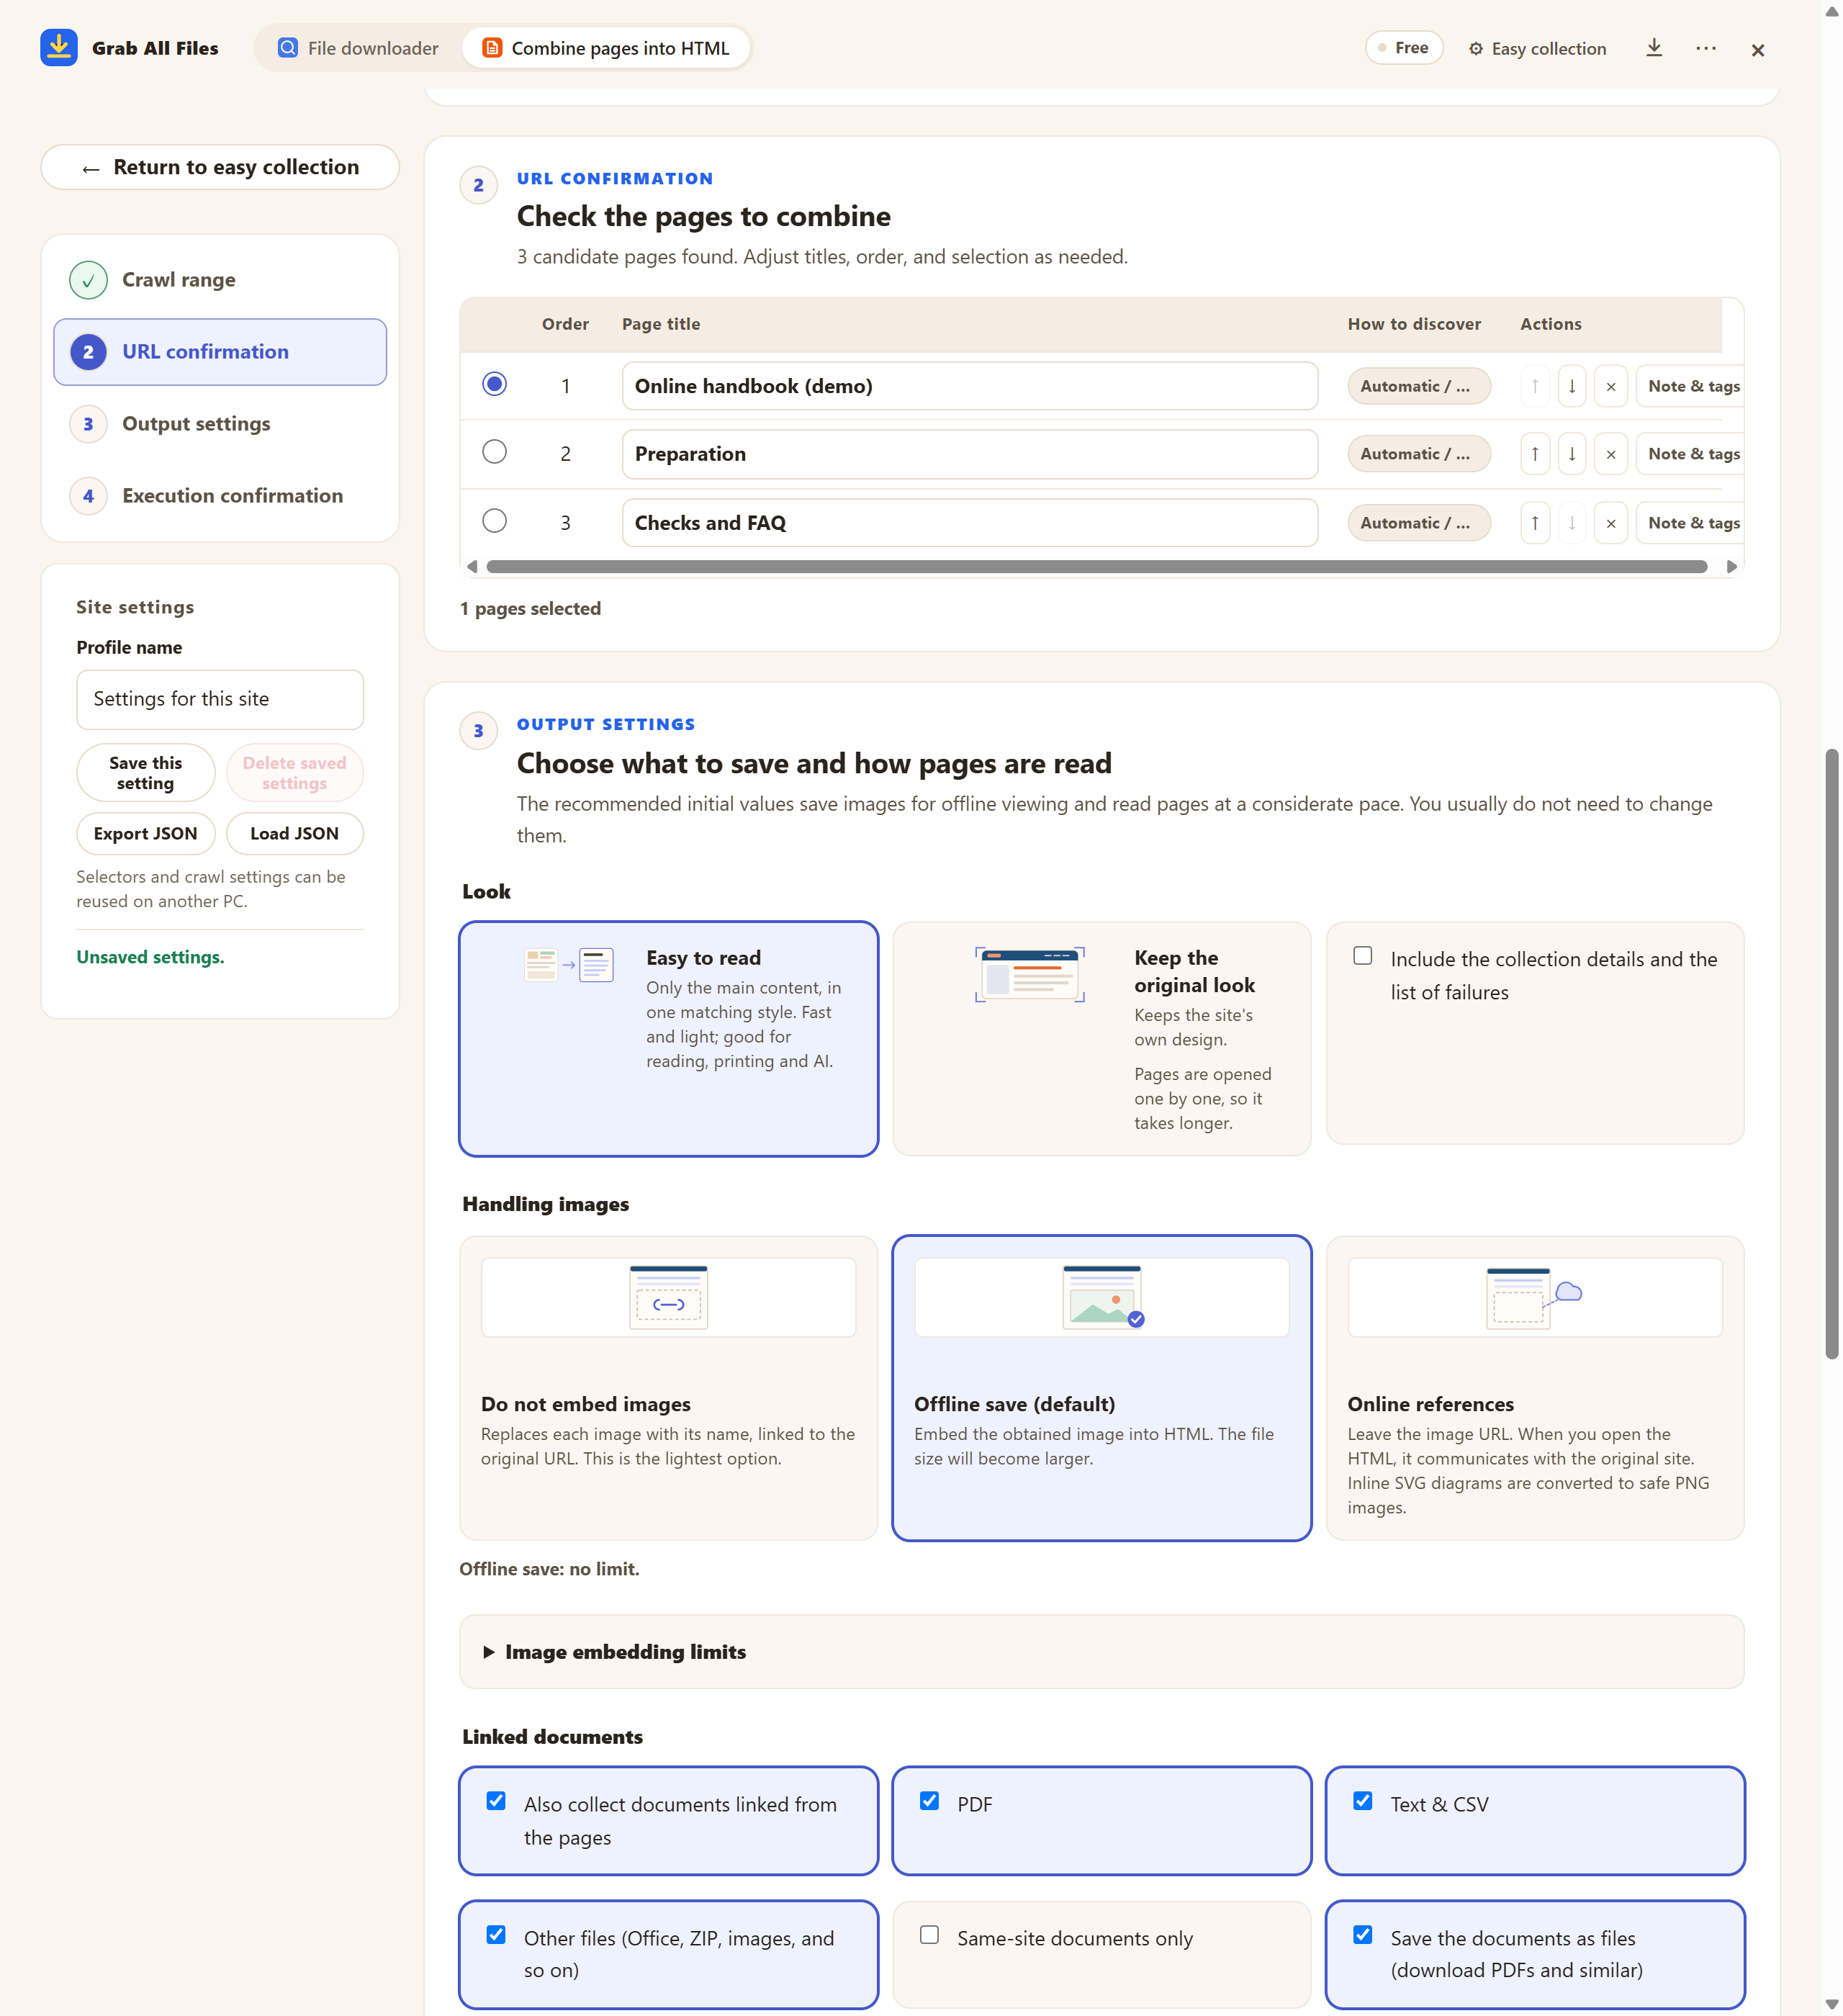
샘플 자료를 사용한 실제 확장 화면입니다. 샘플 매뉴얼 페이지 선택. Free에서 1페이지를 선택한 저장 전 설정·조작 예시입니다. Pro는 이 가이드의 설명대로 여러 선택 페이지를 결합합니다. 영어 UI입니다.
원본 크기로 이미지 열기 ↗


그림과 이름은 확장 프로그램 화면의 카드와 같습니다.
필요한 장을 골라 순서대로 HTML 자료집을 만듭니다. 목차와 본문 검색으로 필요한 부분을 다시 찾습니다.
PDF URL이나 다운로드 링크를 얻을 수 있는지 확인합니다. 파일 다운로드 도구로 PDF를 저장하고 설명 HTML과 함께 관리합니다.
발견된 후보를 메뉴와 비교해 필요한 기사를 골라 순서를 조정합니다. 저장 결과를 원래 기사와 대조합니다.
| 자료 | 관리 방법 |
|---|---|
| HTML 자료집 | 수집한 페이지 본문을 목차와 검색으로 읽습니다. 필요한 장이 실제 저장됐는지 확인합니다. |
| PDF 원본 | 설명 HTML과 함께 별도 파일로 보관합니다. HTML 문서 링크는 PDF 본문을 HTML에 통합하지 않습니다. |
| 자료 메모 | 원래 URL·확인일·매뉴얼에 표기된 버전을 적습니다. 버전 표기가 없을 때도 기록합니다. |
이 자료에 명시된 절차·전제 조건·필요 서류를 정리해 주세요. 근거 원문과 출처 URL을 붙이고 없는 정보는 추측하지 말고 ‘제공 자료에 명시되지 않음’으로 표시해 주세요.
후보와 원래 메뉴를 비교해 필요하면 URL을 추가합니다. 저장 후 제목과 수집 결과도 원문과 비교하면 실제 저장한 자료를 확인할 수 있습니다. 모든 메뉴 항목을 찾았다고 가정하지 않습니다.
파일 다운로드 도구에서 PDF URL이나 다운로드 링크를 확인해 접근 가능한 PDF를 별도 저장합니다. 설명은 HTML로 수집하고 함께 관리하며 PDF 본문은 HTML에 통합되지 않습니다.
네. Free는 후보를 찾고 선택한 1페이지를 HTML로 저장합니다. Pro는 여러 본문을 선택·정렬·결합합니다. 인증·권한·안전 제한은 적용됩니다.
원래 페이지의 개정일·버전 표기를 확인해 URL·확인일과 함께 제목이나 메모에 적습니다. HTML 전체 수집일과 AI 출력의 페이지별 URL·수집일도 대조에 쓸 수 있지만 매뉴얼 버전은 원래 페이지에서 따로 봐야 합니다.
수집 전에 AI 출력을 켜고 수집 후 AI ZIP을 저장해 요청문을 복사합니다. 필요한 파일을 골라(필요하면 압축을 풀고) 외부 AI에 직접 전달합니다. 답변이 제공한 원문과 맞는지 견주어 보세요.
수집은 브라우저의 로그인 상태를 그대로 사용하며 인증 정보를 수집하지 않습니다. “로그인 필요”로 표시되면 “사이트를 열어 로그인”을 누르고 열린 탭에서 로그인한 뒤 “재개”를 누르세요. 계속 로그인이 필요한 페이지는 저장되지 않으며, 남은 페이지 수가 결과에 표시됩니다.
스크롤하거나 클릭한 뒤에야 본문을 보여 주는 사이트가 있습니다. “페이지에서 본문이 빠질 때: 내용 및 JavaScript 설정”을 열고 “아래로 스크롤해 나중에 나타나는 내용 불러오기”나 “‘더 보기’를 눌러 이어지는 내용 포함”을 켠 뒤 다시 수집하세요. 페이지의 다른 부분이 저장되었다면 그곳의 “화면에서 선택”으로 본문 범위를 지정할 수 있습니다.
무료 버전은 파일 일괄 다운로드에서 다운로드당 최대 10개, 페이지를 HTML로 합칠 때는 한 번에 선택한 1페이지를 저장합니다. 그 페이지에 직접 링크된 파일은 “다음 10건 저장”으로 10개씩 저장합니다. Pro($19.99, 1회 결제, 최대 3대)는 다운로드당 제한이 없고 여러 페이지를 하나의 HTML로 합칩니다.