
검색 결과 페이지의 PDF를 저장하고 제목으로 이름을 붙이세요.
법령, 판결, 특허의 공개 데이터베이스는 각 행 뒤에 PDF가 있는 결과 페이지를 보여 줍니다. Grab All Files는 그 페이지를 스캔해 찾은 모든 PDF를 목록으로 보여 주고, 체크한 것을 저장합니다. 문서를 저장할 뿐입니다. 텍스트가 현행인지, 정확한지, 적용되는지는 판단하지 않으며 법률 자문도 하지 않습니다. 수천 건이 필요하다면 제공처가 마련한 일괄 다운로드나 API를 쓰세요.
무엇을 모으는지, 그리고 종류별로 공개되는 방식
| 대표적인 파일 | 결과 페이지의 모습 | 이름(제목은 자동, 나머지는 직접 입력) | |
|---|---|---|---|
| 법령과 규정 | 현행 조문 전체 또는 관보 해당 페이지의 PDF | 제목 목록. 행마다 PDF 링크가 하나 있는 경우가 많음 | 제목. 저장한 날짜는 직접 추가 |
| 판결 | 전문 PDF. 판결문과 요약이 별도의 두 파일인 경우도 있음 | '다음'이 있는 결과 페이지, 행마다 판결 하나 | 제목. 법원, 날짜, 사건번호는 직접 추가 |
| 특허와 실용신안 | 공보 또는 등록 특허의 PDF | 페이지당 수십 행의 검색 결과가 여러 페이지 | 제목. 공개번호는 직접 추가 |
| 지침과 통지 | PDF. Word나 Excel 첨부가 있는 경우도 있음 | 연도별로 묶인 링크 페이지 | 제목. 발행일은 직접 추가 |
파일 이름으로 자동 적용할 수 있는 것은 PDF의 제목(또는 원래 이름)뿐입니다. 법원, 날짜, 사건번호, 공개번호는 대신 넣어 주지 않습니다. 직접 이름을 바꾸거나, 파일 정보 CSV 옆의 시트에 남겨 두세요. 제목에 의존하기 전에 몇 개를 확인하세요.
결과 페이지에서 깔끔한 폴더까지
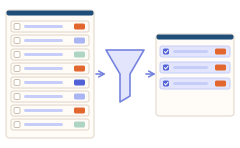
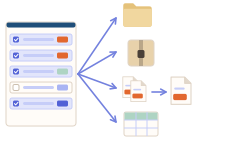
저장하기 전에 목록을 좁힌 뒤, 파일을 어떤 형태로 받을지 고릅니다.
순서
- 1브라우저에서 데이터베이스를 검색하고, 결과 페이지가 허용하는 한 많은 행을 표시하도록 설정합니다.
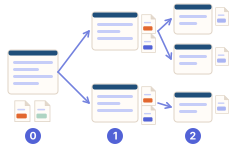
- 2결과 페이지를 연 채로 '파일 일괄 다운로드'를 시작해 스캔합니다. PDF가 결과 페이지가 아니라 각 상세 페이지에 있다면 '깊이 1'을 고릅니다.
- 3목록을 PDF로 좁힙니다. 무료는 화면에 있는 것만 읽으므로, 긴 결과 목록은 스캔하기 전에 끝까지 스크롤하세요. Pro는 스크롤하고 목록의 '다음' 페이지도 대신 따라가며, 기본적으로 스캔 1회에 최대 100페이지입니다.
- 4파일 이름은 'PDF 제목'으로 하고, 작업에 맞는 폴더 정리 방식(유형별, 도메인별, 없음)을 고릅니다.
- 5선택한 파일을 저장합니다. 무료는 1회 저장에 최대 10개이며, 다음 파일을 선택해 저장을 다시 누릅니다.
- 6파일 정보 CSV를 내보냅니다. URL, 파일 이름, 제목, 각 파일을 찾은 페이지가 들어 있어 출처 목록으로 보관할 수 있습니다.
제공처의 방법을 대신 쓰는 경우
- ✓수만 건의 문서나 한 해 전체의 판결: 일괄 다운로드나 API를 찾아보세요.
- ✓PDF가 아니라 구조화된 데이터로 필요한 텍스트: 제공처의 데이터 파일이 더 낫습니다.
- ✓항상 최신이어야 하는 것: 확장 프로그램은 변경을 감시하지 않습니다.
- ✓텍스트가 시행 중인지, 어떻게 적용되는지: 자격 있는 사람과 원본 자료의 몫입니다.
이용 약관과 파일의 성격
공개 데이터베이스는 자동 접근, 복사, 재사용에 대해 자체 규칙을 정해 둡니다. 대량으로 수집하기 전에 읽어 보고, 나누어 저장해서 부하를 적게 유지하세요. Grab All Files는 로그인이나 CAPTCHA를 뚫지 않습니다.
저장한 PDF는 그날 사이트가 제공한 내용의 사본입니다. 목록의 제목 옆에 저장한 날짜를 적어 두고, 정확한 문구가 중요할 때는 원본으로 돌아가세요.
관련 가이드
- 정부·공공기관 문서페이지별, 연도별로 공개하는 정부 사이트.
- PDF 파일 이름 변경·정리코드보다 제목이 더 나은 이름인 이유와, 그래도 직접 바꿔야 하는 것.
- 파일 링크를 CSV로파일 정보 CSV의 열.
자주 묻는 질문
검색 결과 전체를 PDF로 다운로드할 수 있나요?
스캔이 읽는 페이지에서 찾은 PDF 대부분은 저장할 수 있습니다. DRM이 걸린 PDF나 브라우저 내장 PDF 뷰어 안의 PDF는 저장할 수 없습니다. 무료는 1회 저장에 선택한 10개이므로 긴 결과 목록은 여러 번에 나누어 저장하고, Pro는 저장당 제한이 없으며 스크롤하고 '다음' 페이지도 따라갑니다. 매우 큰 묶음은 제공처의 일괄 다운로드나 API를 쓰세요.
PDF에 제목으로 이름이 붙나요?
파일 이름을 PDF의 제목으로 설정할 수 있습니다. 제목은 PDF 자체에서 가져오므로 몇 개를 확인하세요. PDF에 제목이 없으면 파일 이름을 씁니다.
법령이나 판례가 현행인지 알려 주나요?
아니요. 파일을 저장할 뿐입니다. 텍스트가 시행 중인지, 정확한지, 내 사안에 관련되는지는 판단하지 않으며, 이 페이지의 어떤 내용도 법률 자문이 아닙니다.
어느 데이터베이스를 지원하나요?
특정 사이트를 위해 만들어진 것이 아닙니다. 페이지가 링크하거나 불러오는 파일을 찾으므로, 브라우저에서 열 수 있는 페이지에서는 대개 작동합니다. DRM이나 내장 PDF 뷰어 안의 파일처럼 저장할 수 없는 파일이 있으며, 자동 접근에 대한 규칙은 사이트마다 다릅니다.
인용을 위한 출처 목록을 남길 수 있나요?
파일 정보 CSV를 내보내세요. 출처 페이지 열에 각 PDF를 찾은 곳이 나옵니다. CSV에는 저장한 날짜의 열이 없고, 사건번호나 공개번호 같은 고유 식별자도 채워지지 않으므로 시트에서 직접 추가하세요.
브라우저에서 Grab All Files를 사용해 보세요.
무료 플랜은 파일 일괄 다운로드에서 다운로드당 최대 10개, 페이지를 HTML로 합칠 때는 한 번에 선택한 1페이지를 저장합니다. 그 페이지에 직접 링크된 파일은 “다음 파일 10개 저장”으로 10개씩 저장합니다. Pro($19.99, 1회 결제, 최대 3대)는 다운로드당 제한이 없고 여러 페이지를 하나의 HTML로 합칩니다.