
Webページ上のファイルを、整理された1回の作業で一括ダウンロード。
PDF、Office文書、画像、ZIP、CSV、fetch/XHRレスポンスが混在するページでは、手作業の保存に時間がかかります。Grab All Files は検出可能なファイルをメタデータ付きで一覧化し、必要なものだけ選べます。
「ページ上のファイルを保存」の実際の画面
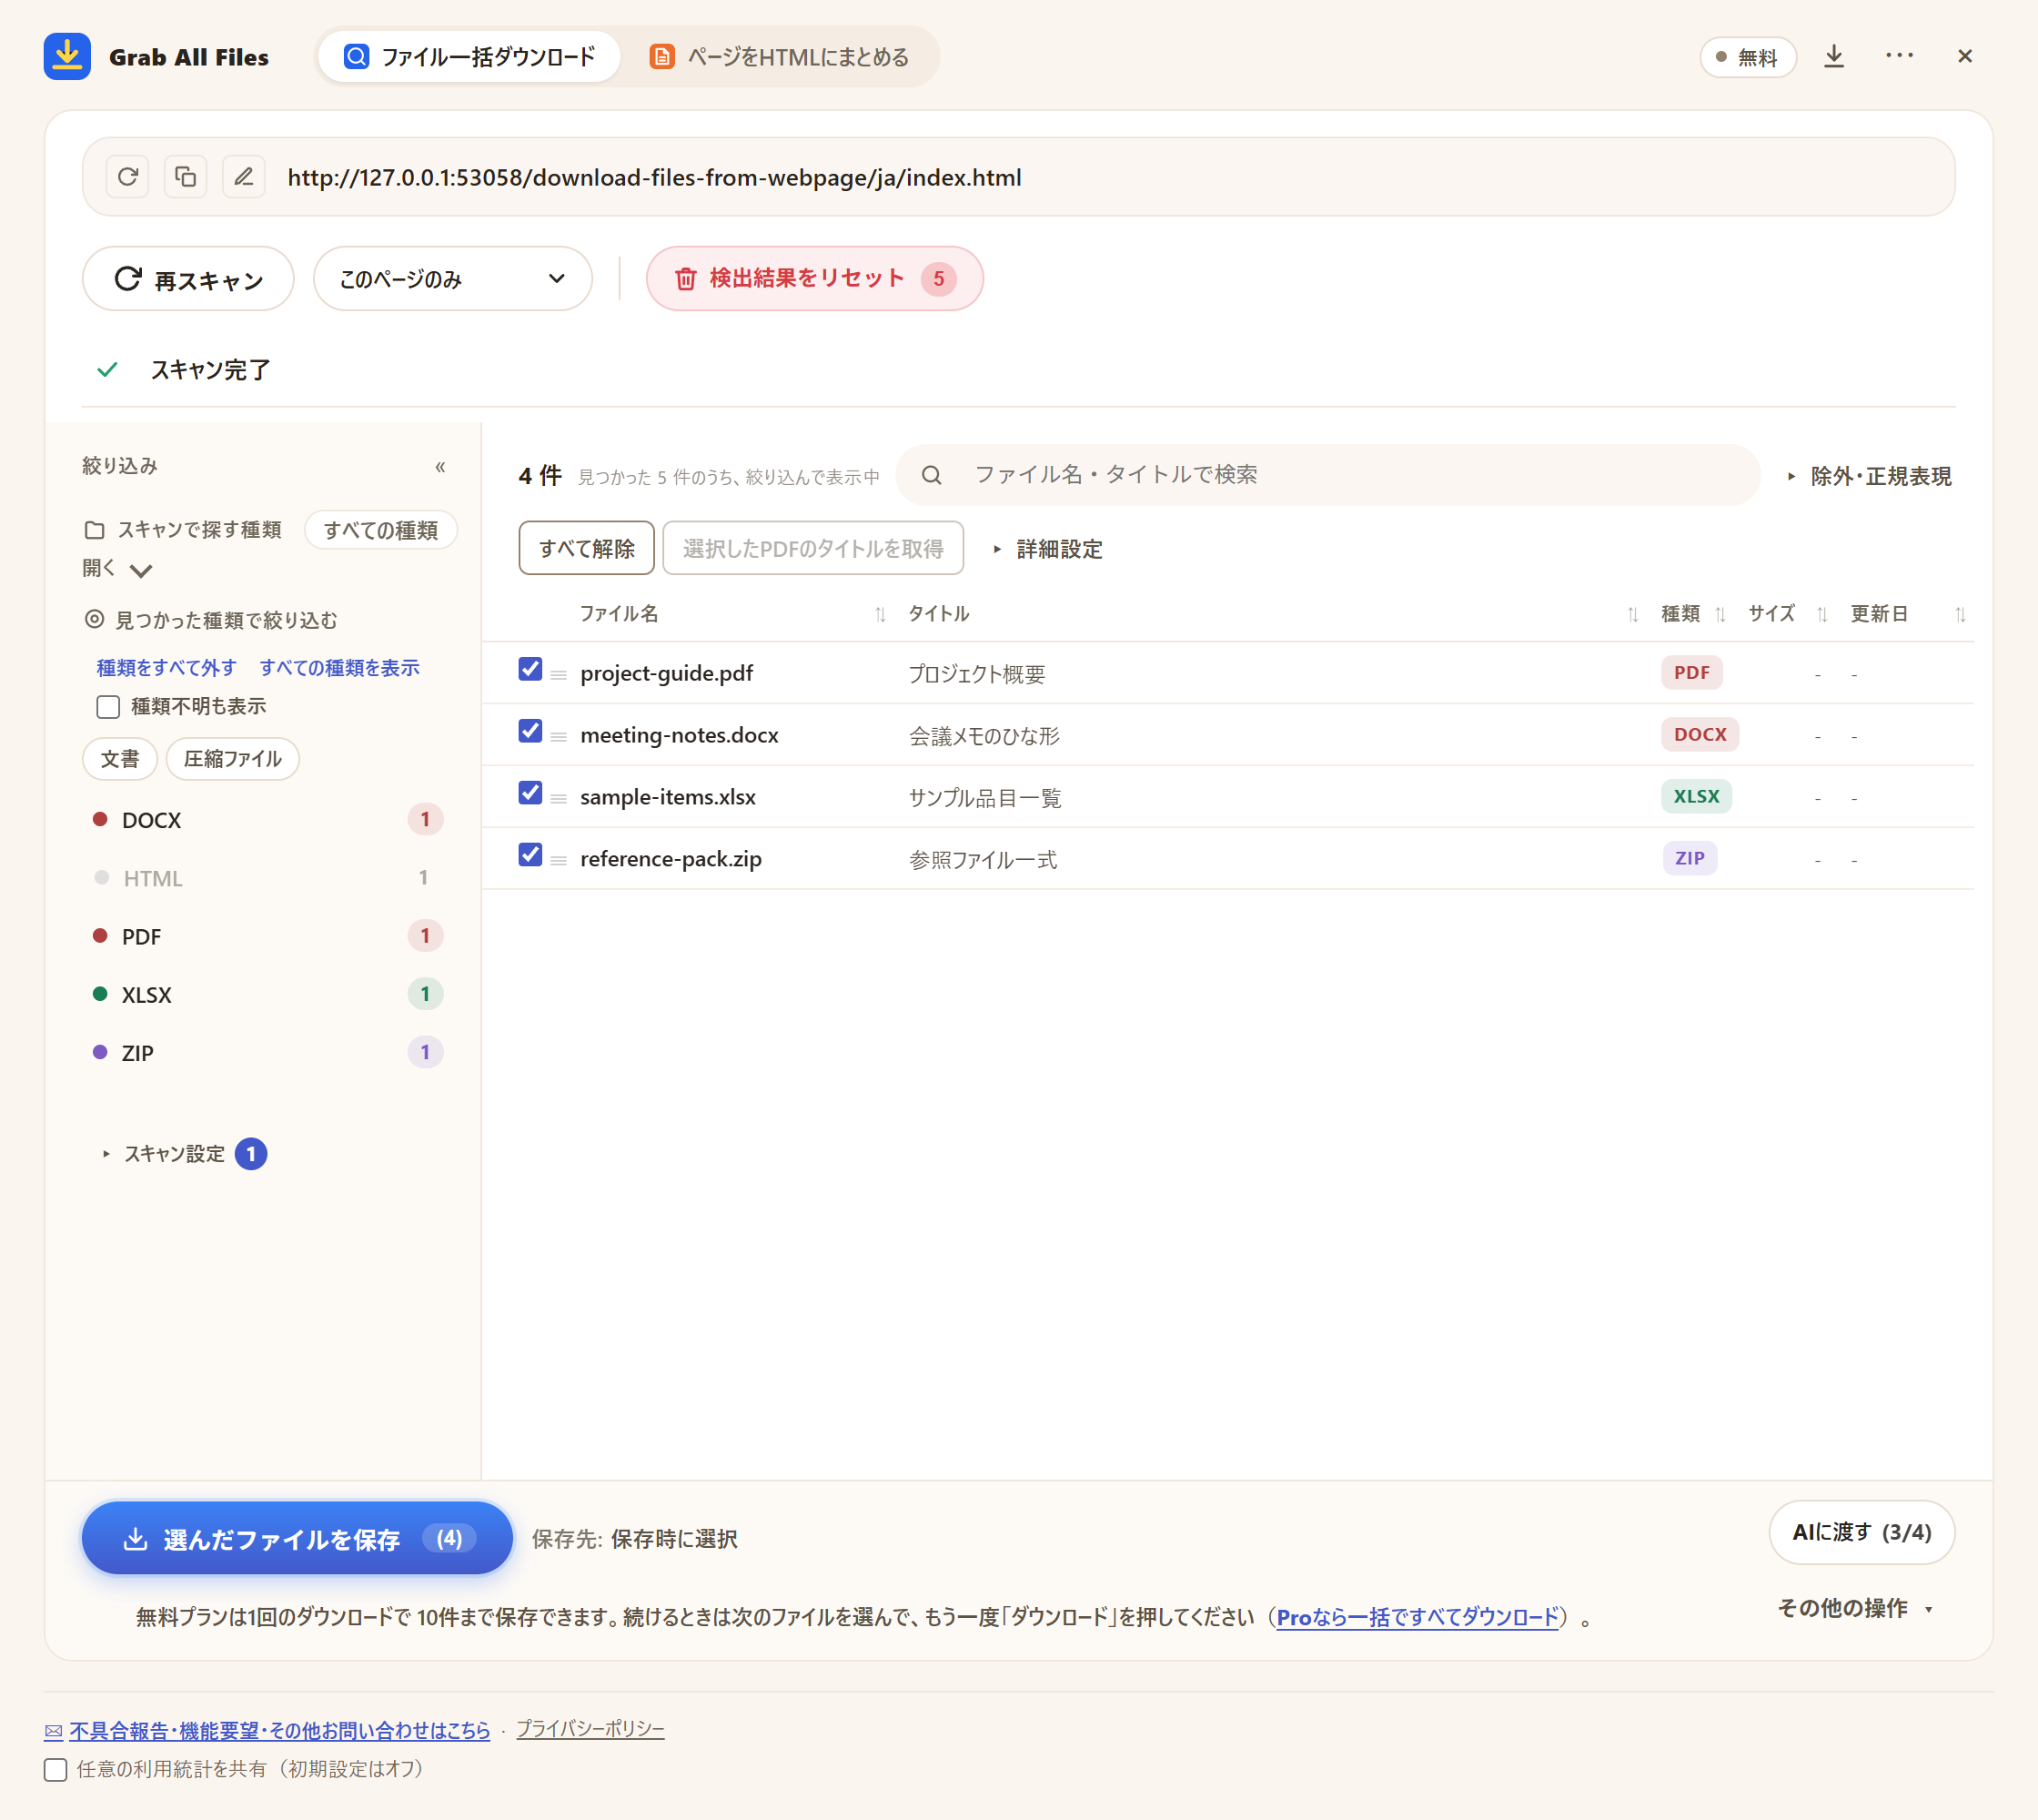
サンプル資料で撮影した拡張機能の画面です。 サンプルページの対応ファイルの選択。
画像を開いて拡大する ↗ファイル一括ダウンロードの流れ
向いている用途
- ✓文書・メディア・圧縮ファイルのリンクが多いページ。
- ✓JavaScript、ビューアー、バックグラウンド通信でファイルが表示されるページ。
- ✓ファイルのURL・サイズ・リンク元ページをCSVで残したい監査・棚卸し。
- ✓クローラーを用意するほどではない単発の収集作業。
使い方
- 1Chrome・Edge・Firefoxで対象ページを開き、ツールバーのGrab All Filesアイコンを押します。いま開いているページのファイル一覧が作られます。
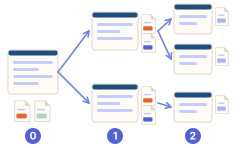
- 2「スキャン」を押します。リンク先のページも調べるときは先に「深さ」を上げます(「このページのみ」はこのページだけ)。リンク先は起点ページのフォルダ配下だけをたどります。
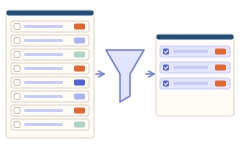
- 3ファイル種類の一覧、ファイル名・タイトルの検索欄、「詳細設定」(最小サイズ・「保存名」)で絞り込み、保存するファイルにチェックを入れます。
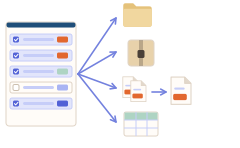
- 4「選んだファイルを保存」を押します。ZIP、「PDF結合」、「整理」、「ファイル情報CSV出力」は「その他の操作」にあります。無料版は1回のダウンロードで10件までです。
- 5件数が多いときは、次のファイルを選んでもう一度「選んだファイルを保存」を押します。失敗した行には理由が表示されるので、アクセスを直してから再試行します。
よくある質問
どのファイル形式に対応していますか?
PDF、Office文書、画像、ZIP、CSVなど、ブラウザからアクセスできるダウンロード可能なレスポンスを検出できます。分割・マルチボリュームアーカイブ(.001、.r00、.z01 など)も検出します。
一部のファイルだけ選べますか?
はい。ファイル種類・名前・タイトル・サイズで絞り込み、列で並べ替えて、必要な行だけにチェックを入れられます。保存ボタンを押すまでは何も保存されません。
無料版に上限はありますか?
無料版は1回のダウンロードで選択した10件まで保存でき、ZIP・「PDF結合」・CSV出力にも同じ上限があります。続けて保存する場合は、次のファイルを選んで同じボタンを押します。Pro($19.99・買い切り、3台まで)は1回あたりの件数上限がありません。
ファイルが見つからない・少ないときは?
スクロールで続きが読み込まれるページは、「スキャン設定」で「スキャン前にスクロールして全て読み込む(ギャラリー・長い一覧)」をオンにして再スキャンします。ファイルがリンク先のページにある場合は「深さ」を上げます。広告ブロッカーはそのサイトで一時停止してください。ページのJavaScriptでダウンロードが始まる場合は、表示される「アクティブ取得」を使います。
ログインが必要なページはどうすればいいですか?
先に同じブラウザでサイトにログインしてからスキャンします。Grab All Filesは既存のログイン状態を使い、深さ1以上ではリンク先のページも同じログイン状態で開きます。代わりにログインしたり、アクセス制限を回避したりはしません。「ログインが必要です」と表示された行は、ログインし直してから再試行してください。
古いHTTPページでも使えますか?
はい。ブラウザで開けるHTTP/HTTPSページをスキャンできます。
関連する用途別ガイド
実際のページで Grab All Files を試せます。
無料版は、ファイル一括ダウンロードでは1回のダウンロードで10件まで、ページのHTML化では1回に選んだ1ページを保存できます。そのページから直接リンクされたファイルは「次の10件を保存」で10件ずつ保存します。Pro($19.99・買い切り、3台まで)は1回あたりの件数上限がなく、複数ページを1つのHTMLにまとめられます。