
Webページ内のPDFを、選んでまとめて保存。
WebページをスキャンしてPDFを一覧にし、タイトル・URL・リンク元を確認して必要なものだけ保存します。無料版は1回の保存で10件まで。続きは次のPDFを選んでもう一度保存できます。検出できる範囲はページの作りやアクセス権限によって変わります。
無料版:1回の保存で10件まで。Pro版($19.99・買い切り)は件数の上限なしで1回に保存できます。見つかる範囲はページの作りとアクセス権限によって変わります。
実際の出力サンプル
このサイトに置いた架空のページを、Grab All Files 5.8.20 で実際に保存したファイルです。作成条件と各ファイルのハッシュ値も載せています。無料版はリリース版で、Pro版は同じソースから作った開発用ビルドで作りました。
「PDFを一括ダウンロード」の実際の画面
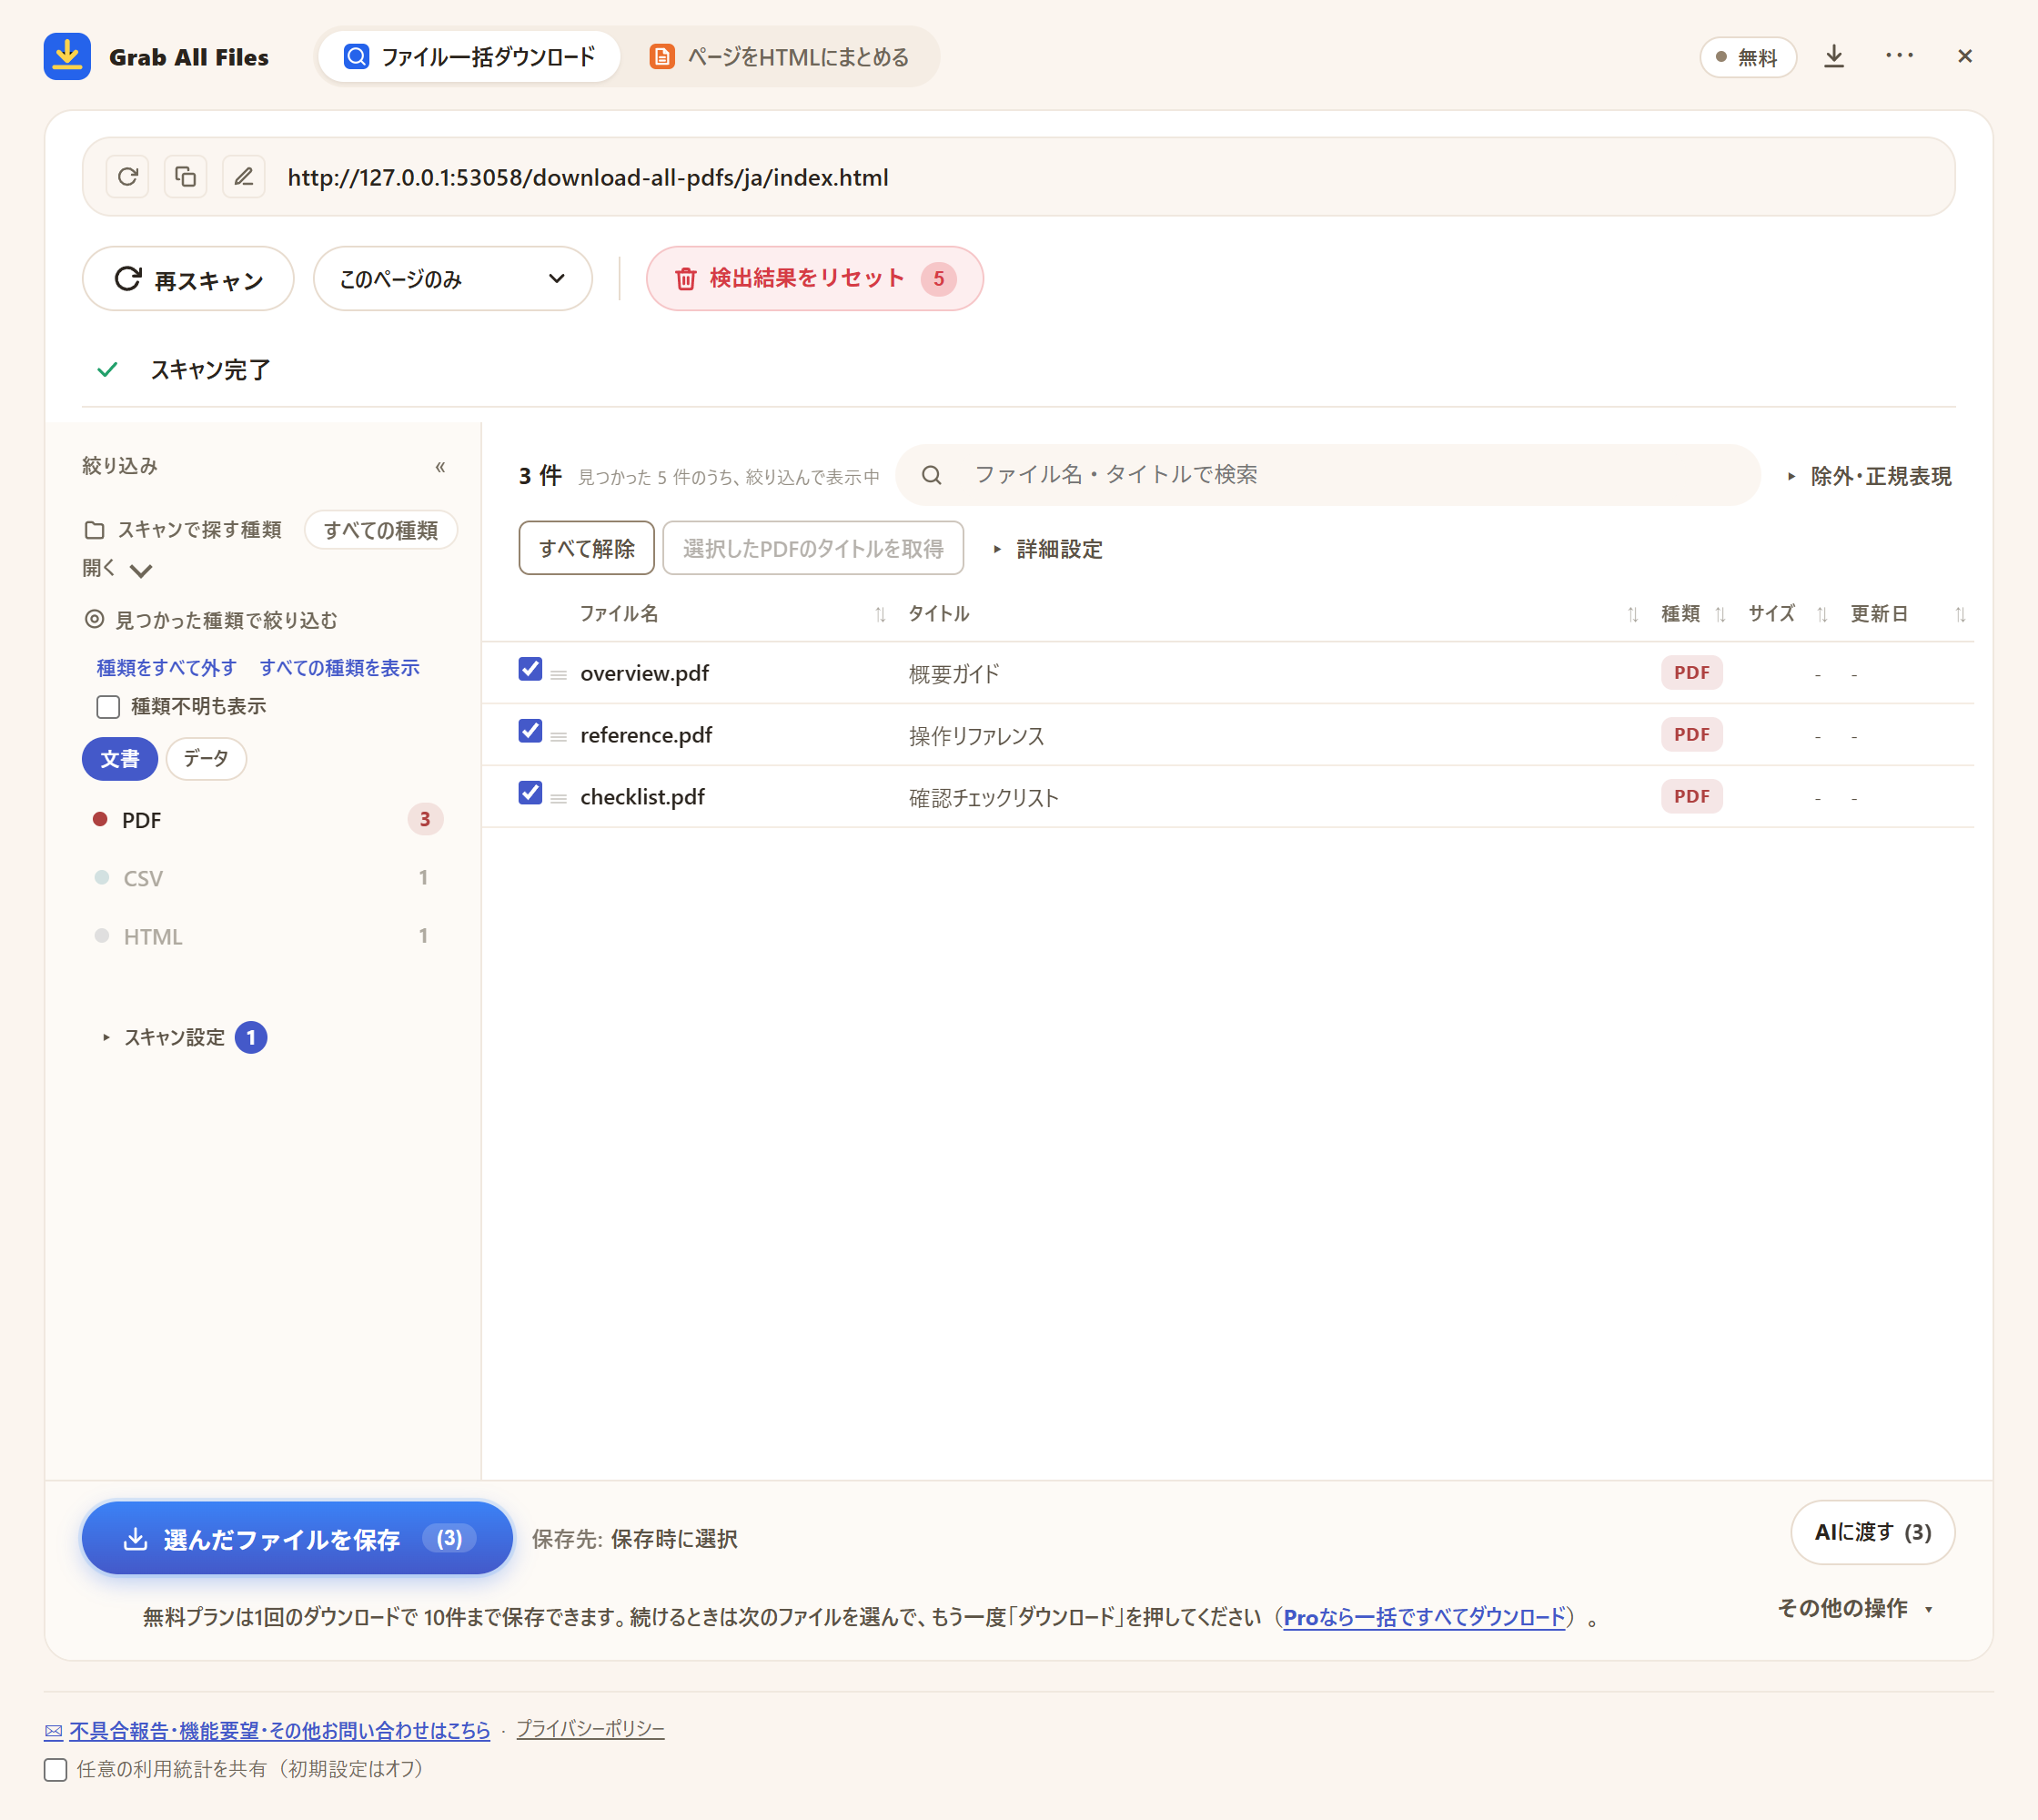
サンプル資料で撮影した拡張機能の画面です。 サンプルページのPDFの絞り込みと選択。
画像を開いて拡大する ↗ファイル一括ダウンロードの流れ
向いている用途
- ✓複数ページに分散した公開報告書、申請書、開示資料。
- ✓大学・研究機関の講義資料、論文、配布PDF。
- ✓直接URLが見えないPDFビューアページ。
- ✓PDFがリンクの1〜2階層先にある講義・アーカイブのフォルダ。
使い方
- 1PDFが並んでいるページを開き、ツールバーのGrab All Filesアイコンを押します。
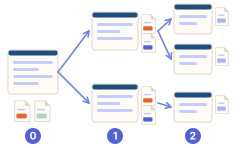
- 2「深さ」を選んでから「スキャン」を押します。「このページのみ」はこのページだけ、深さ1はリンク先のページ(起点ページのフォルダ配下)まで、深さ2はさらにその先まで調べます。深いほど時間がかかります(最大10万ページ)。
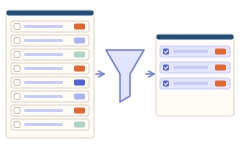
- 3一覧をPDFに絞り込み、各ファイルのタイトル・リンク元ページ・サイズ・URLを確認して、必要なPDFにチェックを入れます。
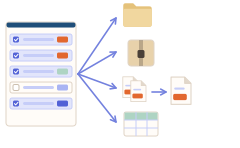
- 4「選んだファイルを保存」を押すか、「その他の操作」からZIPや「PDF結合」を使います。無料版は1回の操作で10件まで。続きは次のPDFを選んで同じボタンをもう一度押します。
このガイドと近い用途
- ページ上のファイルを保存PDF以外のファイル(Office・画像・ZIPなど)もまとめて保存したいとき
- PDFのファイル名変更・整理保存したPDFの名前やフォルダを整えたい場合
- PDFをローカル結合選んだPDFを1つのPDFにまとめたいとき(通常の保存とは別の操作です)
よくある質問
PDFビューアやiframe内のPDFも見つかりますか?
はい。iframe、ビューアURL、fetch/XHRレスポンス、blob URL、CMSルートなど直接リンクが見えにくい場所も確認します。
複数ページをクロールできますか?
はい。深さを上げると、起点ページのフォルダ配下にあるリンク先を巡回します。例えば /~name/course.html が起点なら /~name/ 配下が対象で、大学のサイト全体には広がりません。
PDF結合でファイルはアップロードされますか?
いいえ。PDF結合はブラウザ内でローカル処理されます。
PDFを無料で一括ダウンロードできますか?
はい。無料版はダウンロード・ZIP・PDF結合のいずれも1回の操作で選択した10件までです。続けるときは次のPDFを選んで同じボタンをもう一度押してください。ロックはかかりません。Pro($19.99・買い切り、3台まで)は1回あたりの件数上限がありません。
サイト内のすべてのPDFを必ず保存できますか?
保証はできません。見つかったリンク、巡回の深さ、サイトへのアクセス権限、ブラウザの対応状況によって結果が変わります。失敗したダウンロードは再試行するか、原因付きの失敗URL一覧をCSV出力して確認できます。ログインやサイトの制限を回避する機能ではありません。
ログインが必要なサイトのPDFは?
スキャンの前に同じブラウザでサイトにログインしてください。スキャンと「深さ」によるリンク先の巡回はそのログイン状態を使います。PDFではなくログイン画面が返ってくる場合はセッション切れの可能性が高いので、ログインし直して再試行します。拡張機能が代わりにログインしたり、アクセス制限を回避したりはしません。
関連する用途別ガイド
実際のページで Grab All Files を試せます。
無料版は、ファイル一括ダウンロードでは1回のダウンロードで10件まで、ページのHTML化では1回に選んだ1ページを保存できます。そのページから直接リンクされたファイルは「次の10件を保存」で10件ずつ保存します。Pro($19.99・買い切り、3台まで)は1回あたりの件数上限がなく、複数ページを1つのHTMLにまとめられます。