
Sitemap
Veröffentlicht die Website eine Sitemap, werden die dort aufgeführten URLs zu Kandidaten. Die Zahl der Kandidaten gibt einen groben Hinweis darauf, wie viele Seiten die Website auflistet.
Ein Blog oder ein Nachrichtenbereich ist eine lange Liste von Artikeln mit einem „Weiter“-Link am Ende. Grab All Files findet die Artikel, lässt Sie unerwünschte weglassen und speichert sie als ein HTML mit Inhaltsverzeichnis und Suche, als ein langes druckbares HTML oder als Markdown. In der kostenlosen Version speichern Sie einen Artikel pro Durchlauf; Pro speichert die gesamte Auswahl auf einmal.
Veröffentlicht die Website eine Sitemap, werden die dort aufgeführten URLs zu Kandidaten. Die Zahl der Kandidaten gibt einen groben Hinweis darauf, wie viele Seiten die Website auflistet.
Starten Sie auf der Listenseite des Blogs und sammeln Sie die Seiten unter demselben Pfad, etwa alles unterhalb des Blog-Ordners. Der Rest der Website bleibt außen vor.
Links wie „next“, „Weiter“, „Älter“ und ähnliche werden erkannt. Die Liste wird Seite für Seite verfolgt, um die Kandidaten zu finden. Es werden bis zu 100.000 Kandidaten gefunden.
Die Kandidaten werden mit der Angabe aufgelistet, wie sie gefunden wurden. Darunter wählen Sie das Aussehen und eine von vier Formen.
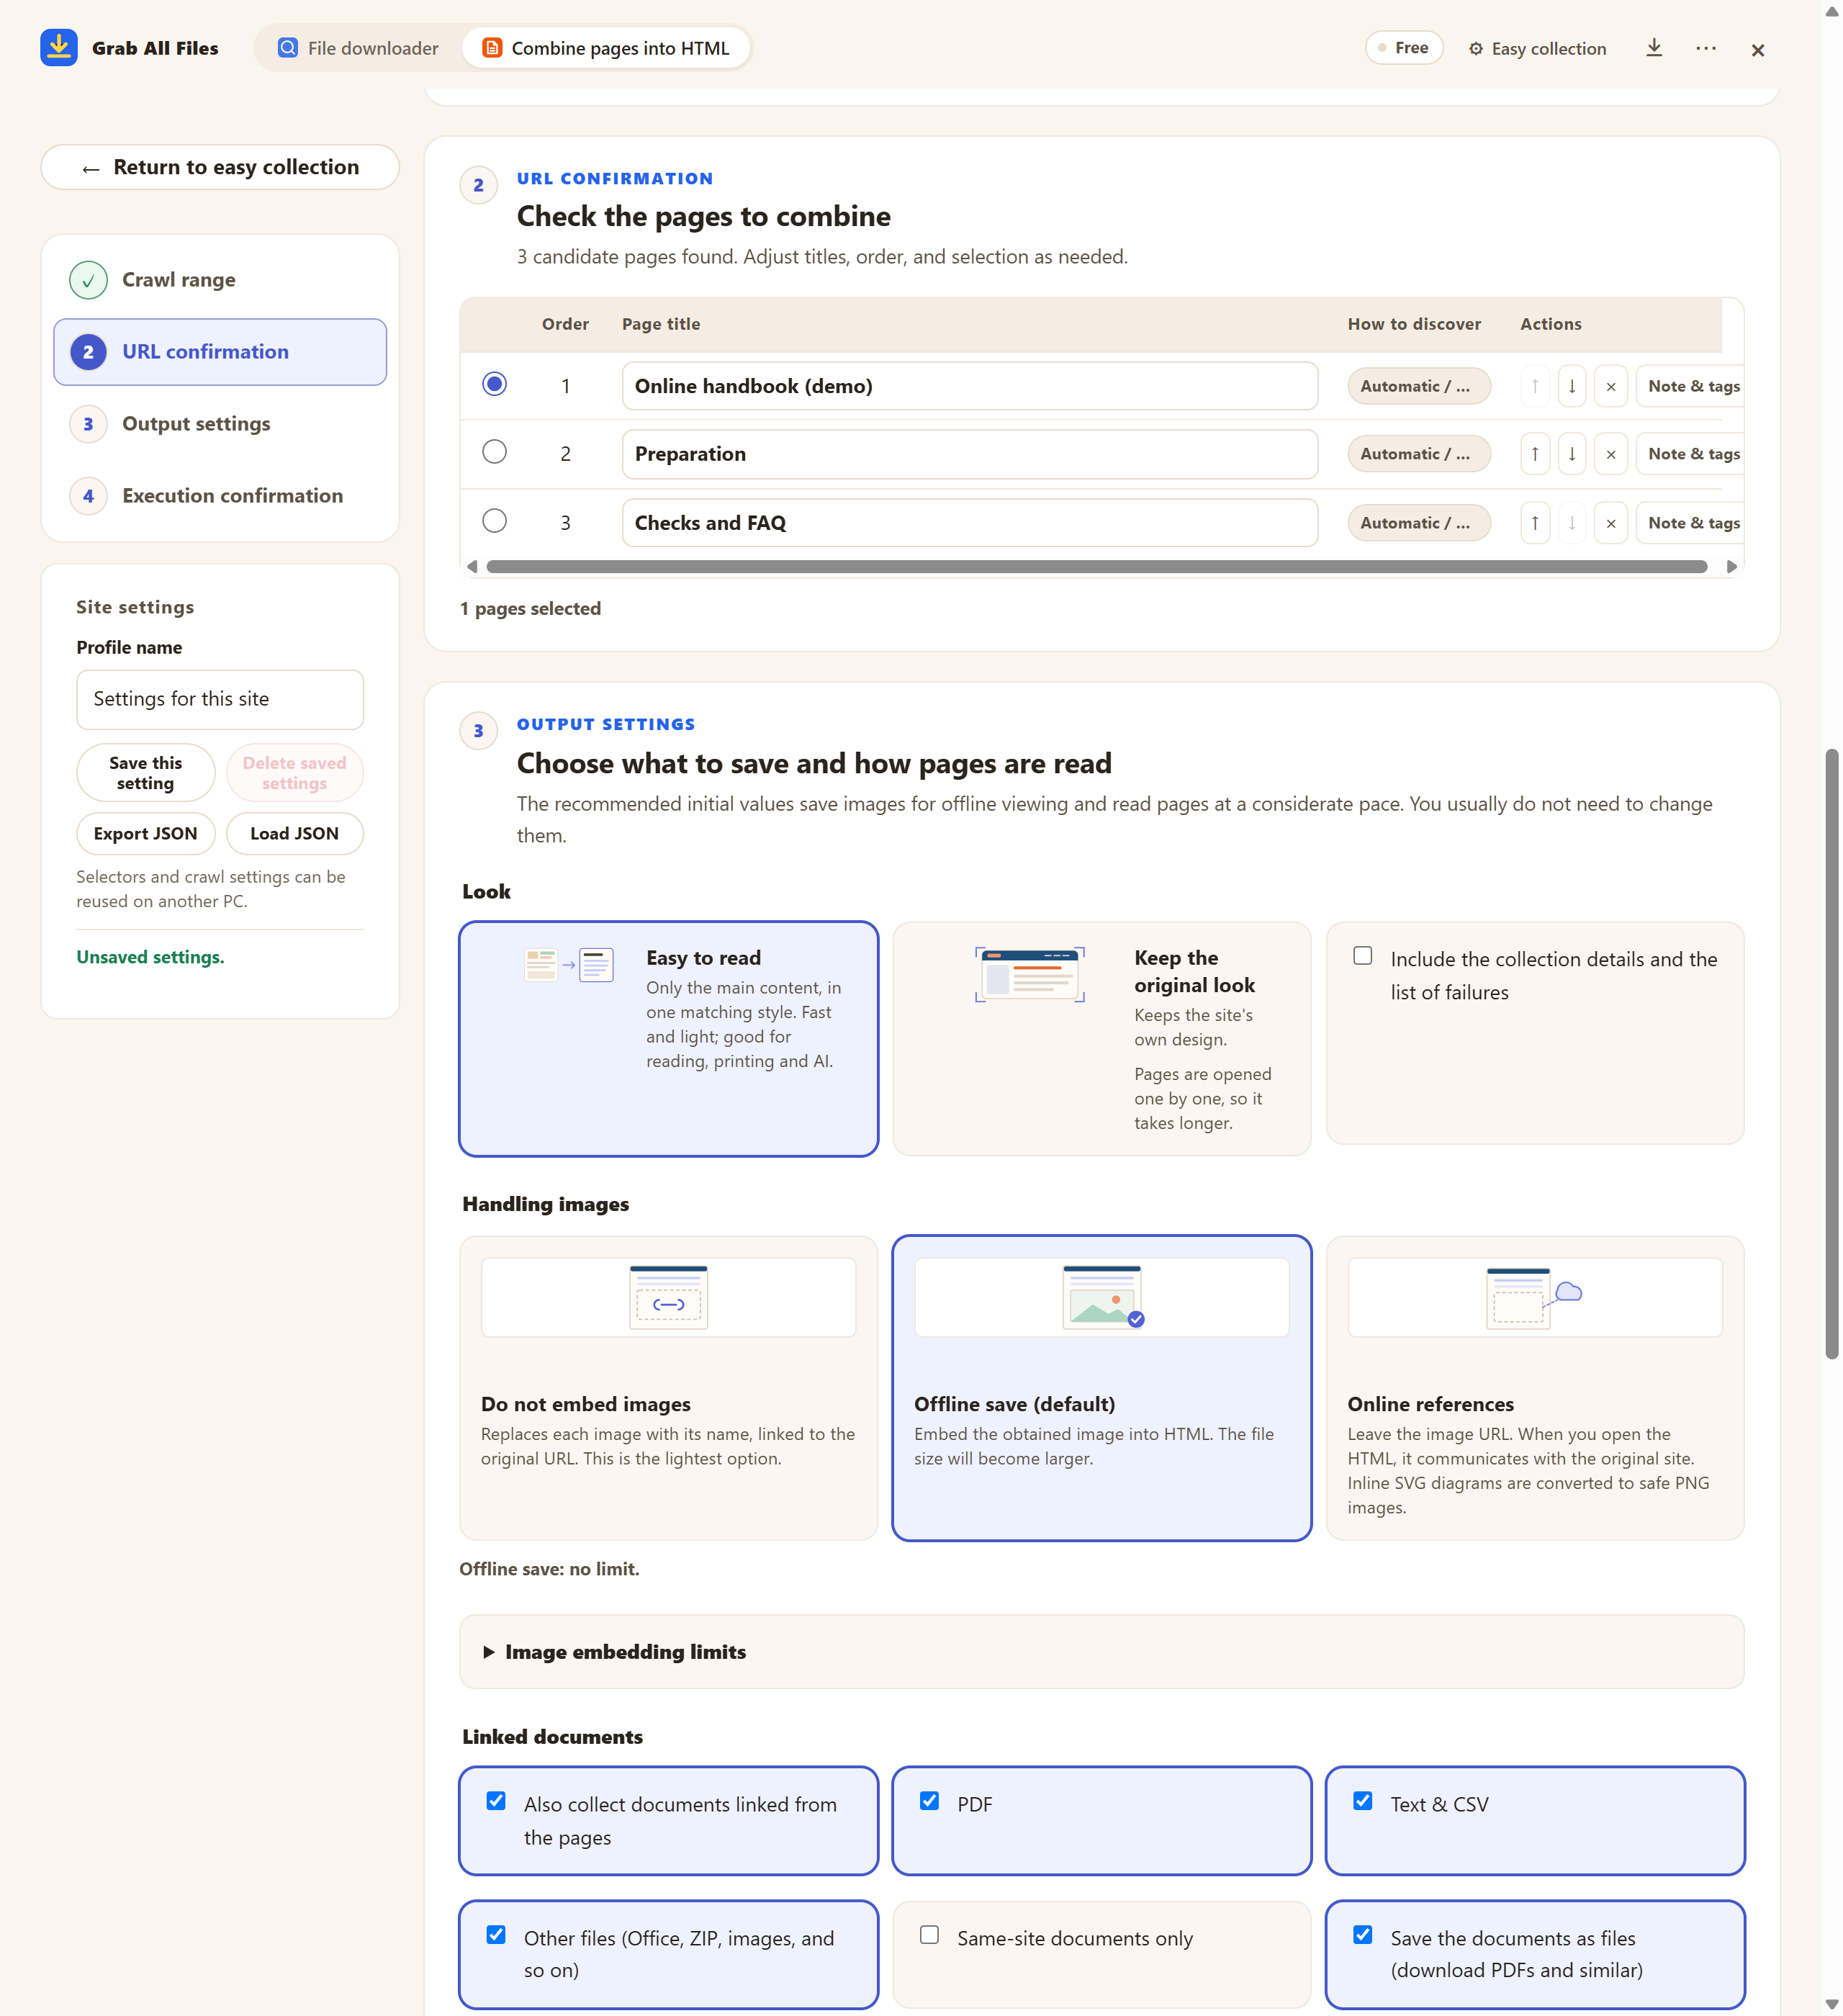
Der echte Bereich in der kostenlosen Version, mit drei Kandidatenseiten. Jede Zeile hat Schaltflächen zum Verschieben oder Entfernen. Darunter wird zuerst das Aussehen gewählt, dann eine der vier Formen.
| Form | Was Sie erhalten | Gut für |
|---|---|---|
| HTML mit Inhaltsverzeichnis und Suche | Alle Artikel in einer HTML-Datei, mit Inhaltsverzeichnis und Suchfeld | Lesen am Bildschirm und eine Wendung in Hunderten von Artikeln finden. Die kleinste der Formen. |
| Vertikal verbundenes HTML (zum Drucken) | Artikel von oben nach unten verbunden, beim Drucken mit Seitenumbruch dazwischen | Drucken oder ein PDF: Nutzen Sie den Druckdialog des Browsers und speichern Sie als PDF. Grab All Files erstellt das PDF nicht selbst. |
| Markdown | Eine Markdown-Datei oder eine pro Artikel, mit source_url und captured_at auf jeder Seite | Notizen, ein persönliches Archiv oder die Weitergabe des Textes an einen KI-Dienst Ihrer Wahl. Siehe die Markdown-Anleitung unten. |
Für Artikel ist „Gut lesbar“ meist das richtige Aussehen: Es ist schneller, und die Datei ist leichter. „Ursprüngliches Aussehen behalten“ bewahrt Layout, Schriften und Bilder jedes Artikels, auf Kosten eines längeren Durchlaufs und einer größeren Datei.
Grab All Files liest jeden Artikel im Browser, daher dauert ein Durchlauf über Tausende Artikel lange und erzeugt eine sehr große Datei. Für ein Nachrichtenarchiv dieser Größe ist ein Website-Kopierer für den Desktop, der die Seiten direkt beim Server anfordert, die bessere Wahl, auch wenn er Seiten hinter Ihrer Anmeldung nicht sehen kann.
Eine Liste, die beim Scrollen weitere Einträge nachlädt, statt „Weiter“-Links zu nutzen, ist ein anderer Fall. Lesen Sie die Anleitung zum endlosen Scrollen, bevor Sie beginnen.
Öffnen Sie die Listenseite des Blogs, wählen Sie die Sitemap, „Gleicher Pfad“ oder „Den Links auf dieser Seite folgen“, lassen Sie die Nicht-Artikel-Seiten aus der Kandidatenliste weg und speichern Sie mit Pro in einem Durchlauf. In der kostenlosen Version speichern Sie einen Artikel pro Durchlauf und fügen die übrigen einzeln hinzu.
Ja. Links wie „next“, „Weiter“ und „Älter“ werden erkannt und verfolgt, um Kandidaten zu finden. Mit Pro kann es außerdem alle folgenden Seiten in einem Durchlauf speichern.
Speichern Sie als „Vertikal verbundenes HTML (zum Drucken)“, öffnen Sie es im Browser und speichern Sie über den Druckdialog als PDF. Jeder Artikel beginnt beim Drucken auf einer neuen Seite.
Speichern Sie als „HTML mit Inhaltsverzeichnis und Suche“. Die eine HTML-Datei hat ein Inhaltsverzeichnis und ein Suchfeld, das offline im Browser funktioniert.
Kommentarbereiche sind eine eigene Aufgabe. Siehe die Anleitung zum Speichern und Auswerten von Kommentaren; diese Seite behandelt die Artikel selbst.
Die kostenlose Version speichert im Datei-Downloader bis zu 10 Dateien pro Download und beim Bündeln von Seiten eine gewählte Seite pro Durchgang; deren verlinkte Dateien werden mit „Nächste 10 Dateien speichern“ in Zehnergruppen gespeichert. Pro (19,99 $, einmalig, bis zu 3 Geräte) hebt das Download-Limit auf und bündelt mehrere Seiten in einem HTML.