
Mapa do site
Se o site publica um mapa do site, as URLs listadas nele viram candidatas. O número de candidatas é uma estimativa aproximada de quantas páginas o site lista.
Um blog ou uma seção de notícias é uma longa lista de artigos com um link “Próximo” no fim. O Grab All Files encontra os artigos, deixa você descartar os que não quer e os salva como um HTML com índice e pesquisa, um HTML longo para impressão ou Markdown. No plano gratuito você salva um artigo por execução; o Pro salva a seleção inteira de uma vez.
Se o site publica um mapa do site, as URLs listadas nele viram candidatas. O número de candidatas é uma estimativa aproximada de quantas páginas o site lista.
Comece pela página de lista do blog e colete as páginas sob o mesmo caminho, como tudo o que está abaixo da pasta do blog. O restante do site fica de fora.
Links marcados como next, “Próximo”, “Mais antigas” e semelhantes são reconhecidos. A lista é seguida página por página para achar as candidatas. São encontradas até 100.000 candidatas.
As candidatas são listadas com a indicação de como cada uma foi encontrada. Abaixo delas você escolhe a aparência e uma das quatro formas.
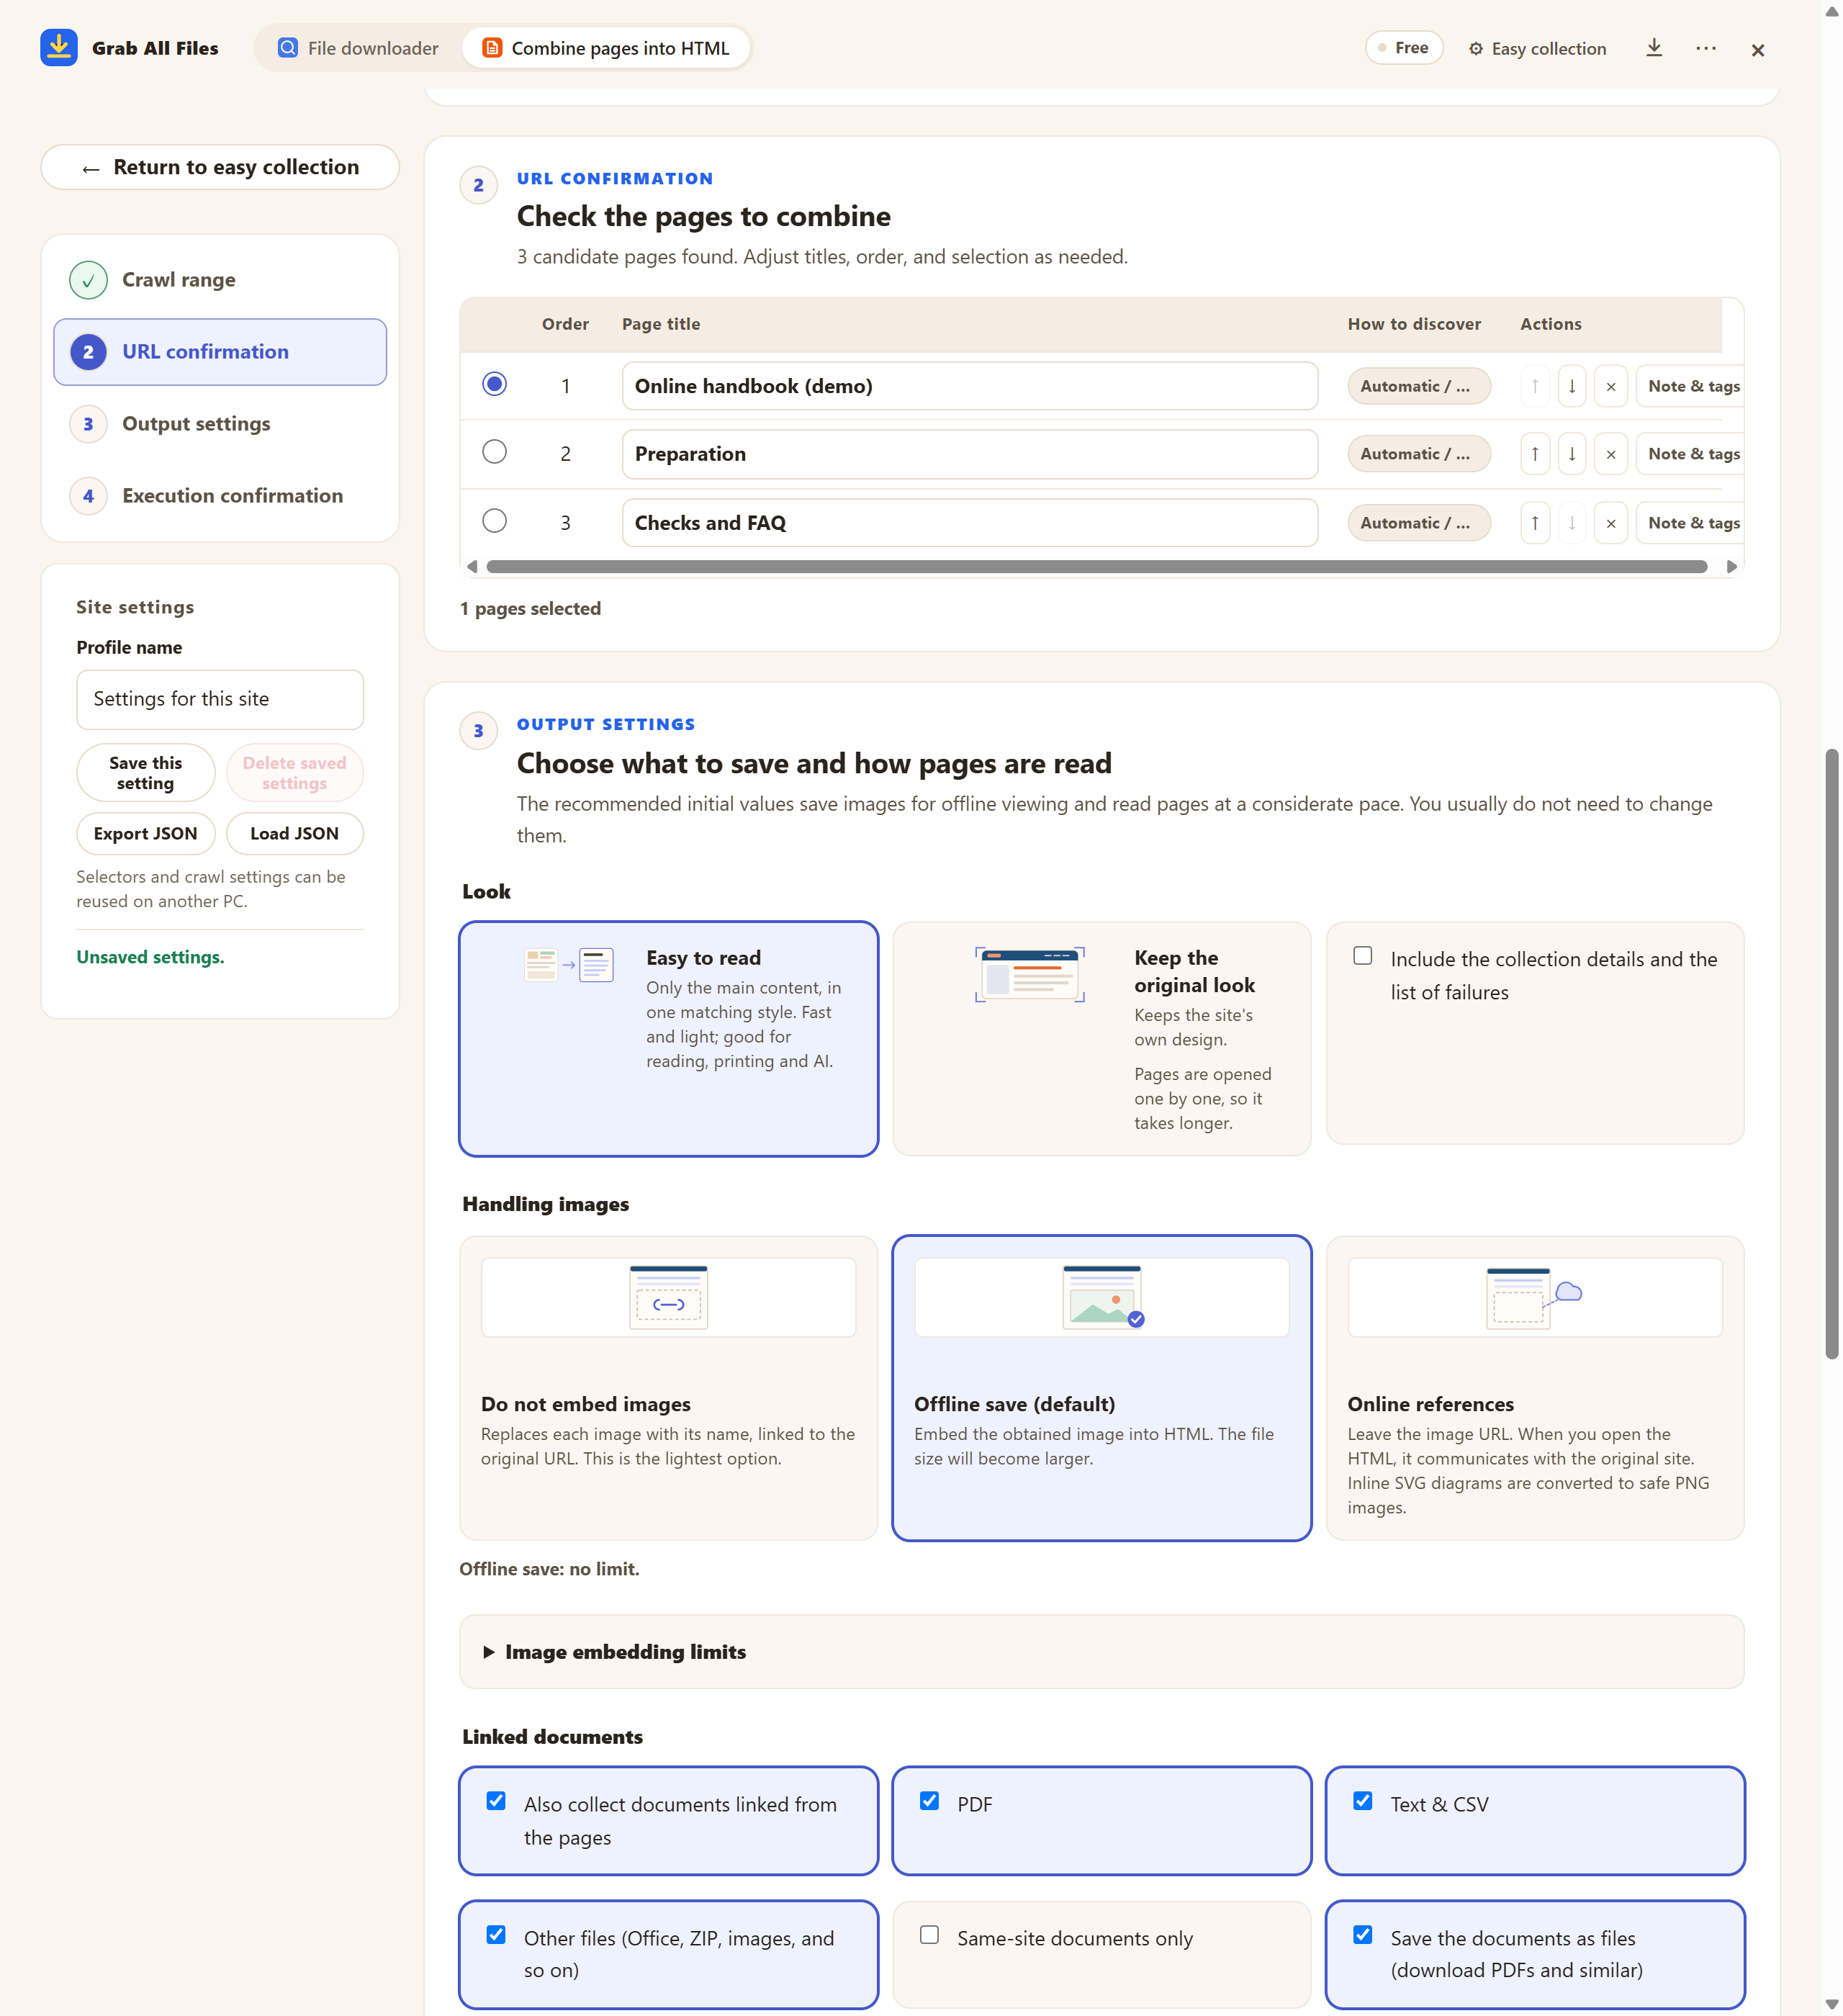
O painel real no plano gratuito, com três páginas candidatas. Cada linha tem botões para movê-la ou removê-la. Abaixo, escolhe-se primeiro a aparência e depois uma das quatro formas.
| Forma | O que você recebe | Bom para |
|---|---|---|
| HTML com índice e pesquisa | Todos os artigos em um arquivo HTML, com índice e caixa de pesquisa | Ler na tela e achar uma frase entre centenas de artigos. A menor das formas. |
| HTML vertical (para impressão) | Artigos unidos de cima para baixo, com quebra de página entre eles na impressão | Imprimir, ou gerar um PDF: use a caixa de impressão do navegador e salve como PDF. O Grab All Files não cria o PDF por conta própria. |
| Markdown | Um arquivo Markdown, ou um por artigo, com source_url e captured_at em cada página | Anotações, um arquivo pessoal ou entregar o texto a um serviço de IA que você escolher. Veja o guia de Markdown abaixo. |
Para artigos, “Fácil de ler” costuma ser a aparência certa: é mais rápida e o arquivo fica mais leve. “Manter a aparência original” mantém o layout, as fontes e as imagens de cada artigo, ao custo de uma execução mais longa e um arquivo maior.
O Grab All Files lê cada artigo dentro do navegador, então uma execução com milhares de artigos leva muito tempo e gera um arquivo enorme. Para um arquivo de notícias desse tamanho, um copiador de sites para computador, que pede as páginas direto ao servidor, é a melhor escolha, embora ele não enxergue páginas atrás do seu login.
Uma lista que carrega mais itens conforme você rola a página, em vez de usar links “Próximo”, é outro caso. Leia o guia sobre rolagem infinita antes de começar.
Abra a página de lista do blog, escolha o mapa do site, “Mesmo caminho” ou “Seguir os links desta página”, tire da lista de candidatas as páginas que não são artigos e salve com o Pro em uma só execução. No plano gratuito você salva um artigo por execução e acrescenta os demais um de cada vez.
Sim. Links como next, “Próximo” e “Mais antigas” são reconhecidos e seguidos para achar candidatas. Com o Pro ele também pode salvar todas as páginas seguintes em uma só execução.
Salve como “HTML vertical (para impressão)”, abra no navegador e use a caixa de impressão para salvar como PDF. Cada artigo começa em uma nova página na impressão.
Salve como “HTML com índice e pesquisa”. O único arquivo HTML tem um índice e uma caixa de pesquisa que funciona offline no navegador.
As seções de comentários são outra tarefa. Veja o guia sobre salvar e analisar comentários; esta página trata dos artigos em si.
A versão gratuita salva até 10 arquivos por download no baixador de arquivos e uma página escolhida por vez ao juntar páginas em HTML; os arquivos vinculados dessa página são salvos de 10 em 10 com “Salvar os próximos 10 arquivos”. O Pro ($19.99, compra única, até 3 dispositivos) remove o limite por download e junta várias páginas em um HTML.